Zero-shot Classification (Y/N)
Zero-shot Classification (zero-shot-классификация) — это способ определить, к какой категории относится текст, изображение или другой объект, когда модель не видела ни одного размеченного примера именно этих категорий. Классы задаются в момент запроса: названием, описанием или инструкцией в промпте. Модель опирается на знания, полученные при предварительном обучении.
В эпоху больших языковых моделей этот подход стал повседневным инструментом. Он лежит в основе разметки отзывов, маршрутизации обращений, модерации и определения тональности, а в GEO помогает анализировать, как нейросети упоминают бренды.
Что такое zero-shot classification простыми словами
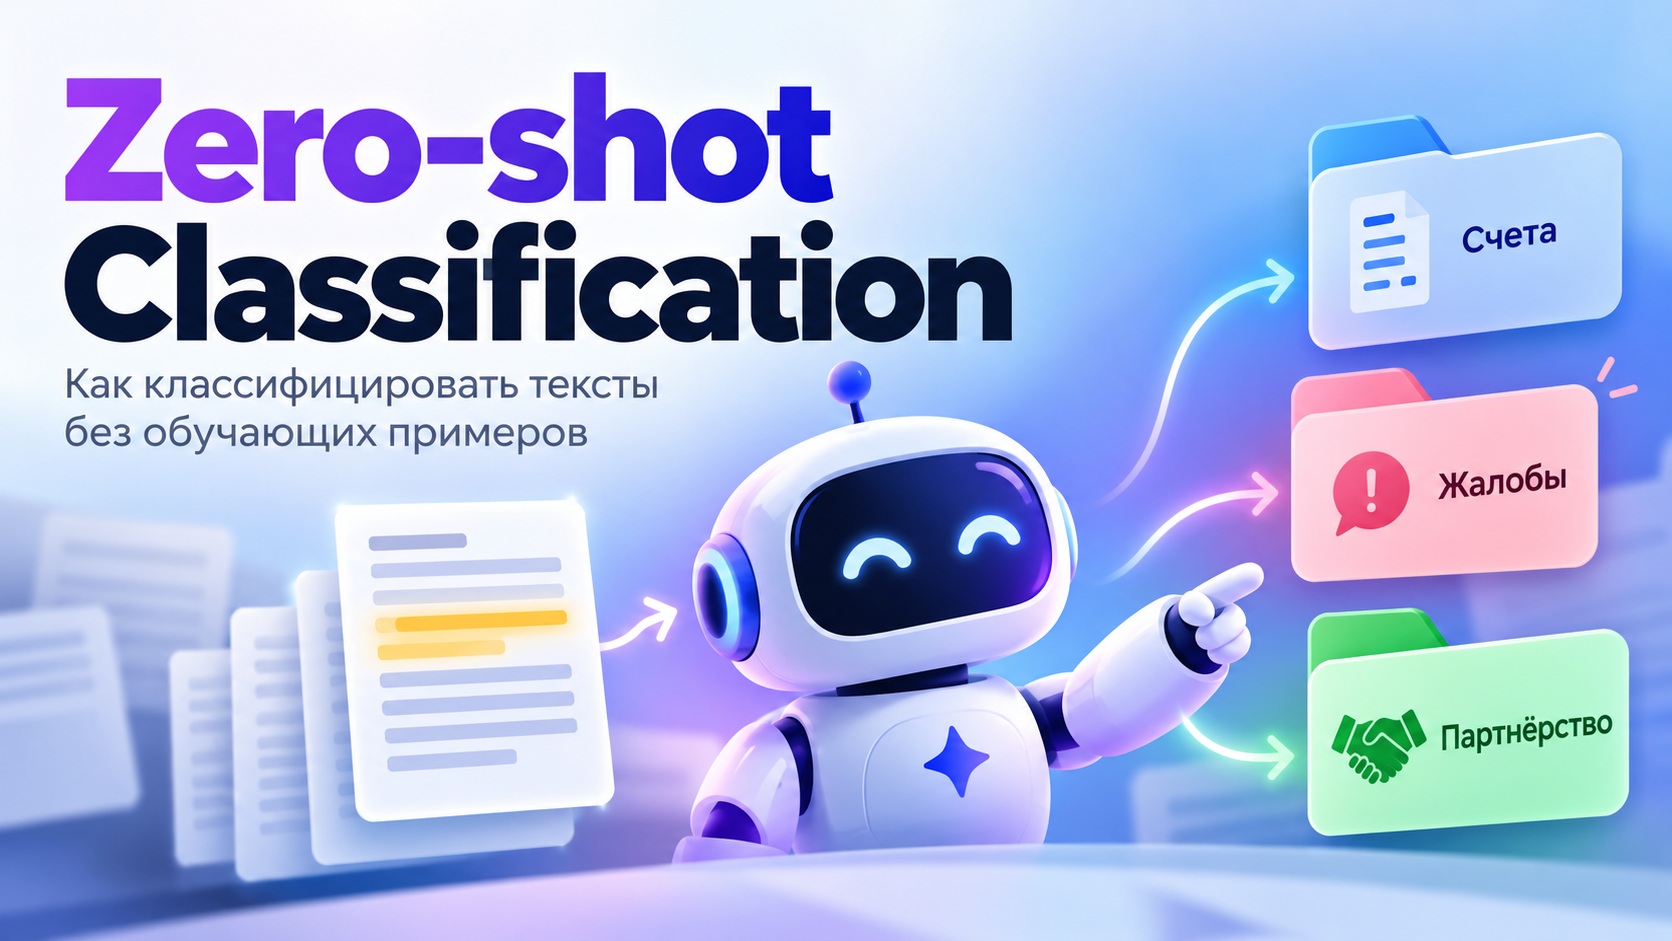
Представьте нового сотрудника, которому дали стопку писем и три папки: «Счета», «Жалобы», «Партнерство». Примеров ему не показывали, есть только названия папок. Он читает письмо, понимает смысл и раскладывает его по папкам. Так же работает zero-shot-классификация.
В научных работах zero-shot классификацию текста описывают так: модели дают текст и набор возможных меток, а она должна выбрать подходящую. Метки могут обозначать разные признаки. Например, тему текста — «спорт» или «политика», эмоцию — «радость» или «гнев», ситуацию — «медицинская помощь» или «нехватка воды».
Есть и более строгое понятие — label-fully-unseen. В этом случае модель решает задачу без обучающих примеров, связанных с конкретными классами. В бизнесе под zero-shot чаще понимают более практичный сценарий: свои данные не нужно размечать и использовать для дообучения. Достаточно задать модели список классов и объяснить, что они означают.
Термин zero-shot learning используют и в других областях. Например, в компьютерном зрении модель может определять содержимое изображения по текстовым описаниям классов. Принцип остается тем же: модель работает с категориями, на которых ее специально не обучали для конкретной задачи.
Где применяется zero-shot classification
|
Сфера |
Задача |
Пример меток |
|---|---|---|
|
Клиентская поддержка |
Маршрутизация обращений |
«возврат», «доставка», «оплата», «техпроблема» |
|
Маркетинг и аналитика |
Разметка отзывов и упоминаний |
«цена», «качество», «сервис», «скорость» |
|
Модерация |
Фильтрация контента |
«спам», «оскорбление», «допустимо» |
|
Документооборот |
Сортировка документов |
«договор», «акт», «счет», «претензия» |
|
GEO и AI-поиск |
Анализ ответов нейросетей о бренде |
«рекомендуют», «нейтрально», «критикуют», «не упоминают» |
Главная причина популярности очевидна. Набор меток можно менять за минуты, а сбор и разметка обучающей выборки для классического подхода занимают недели.
Как работает zero-shot classification: три основных подхода
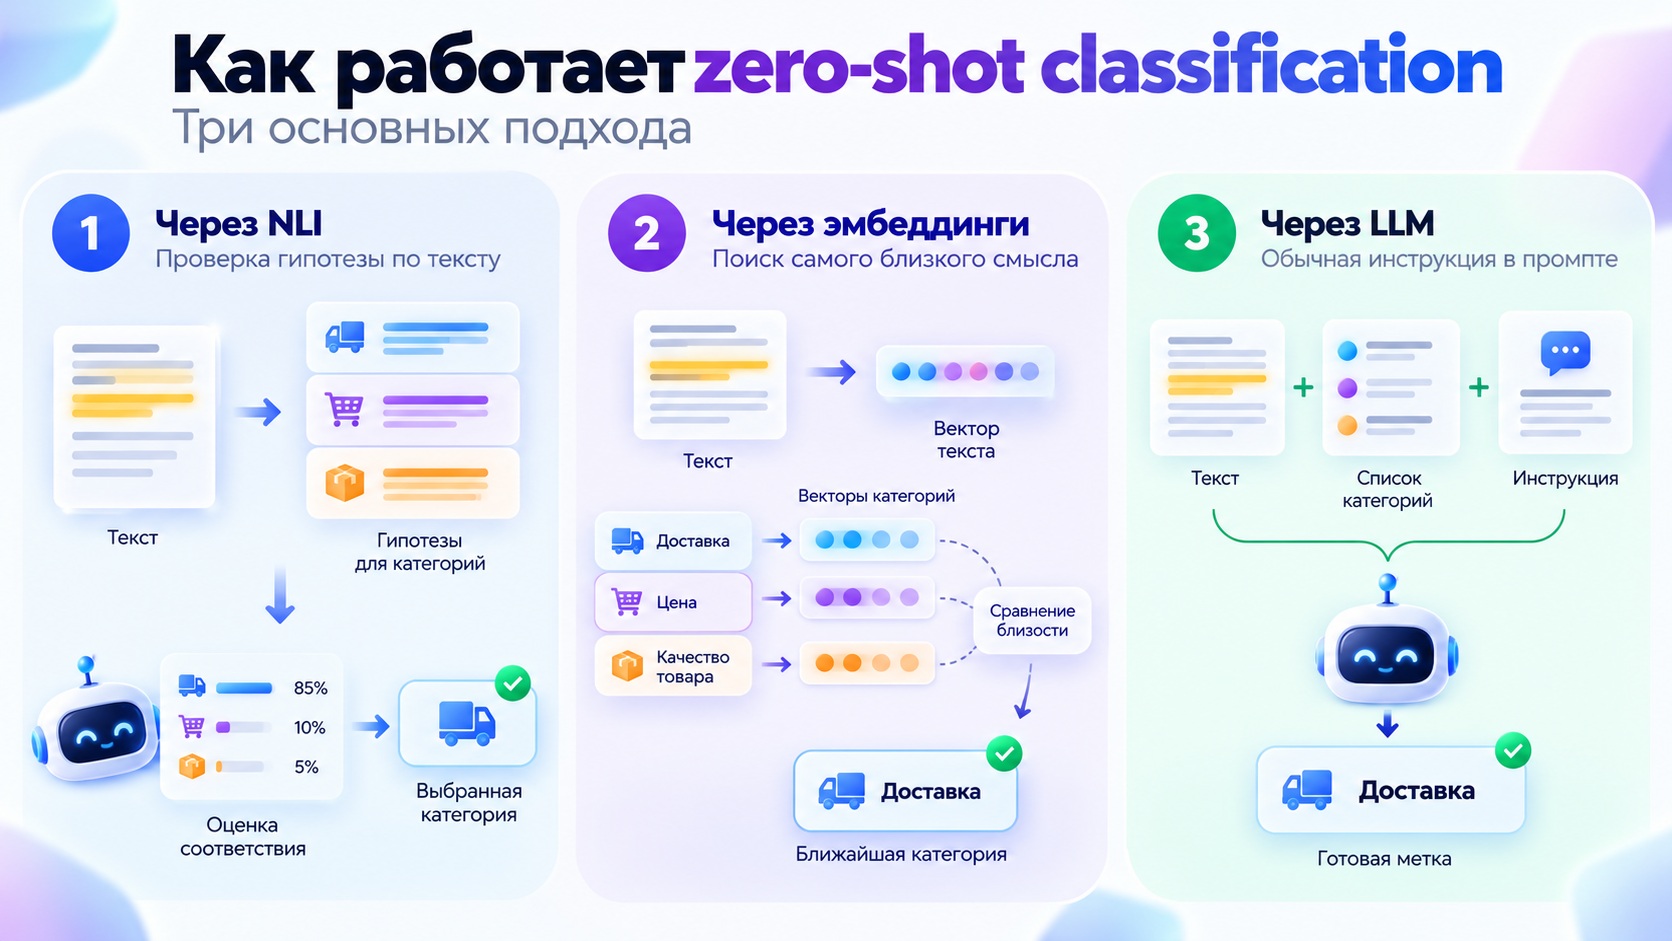
1. Через NLI — проверку гипотезы по тексту
Один из распространенных способов — превратить классификацию в проверку простой гипотезы.
Допустим, есть отзыв: «Доставка задержалась на неделю, никто не отвечает».
И три возможные категории:
- доставка;
- цена;
- качество товара.
Для каждой категории модель составляет отдельное утверждение: «Этот текст о доставке», «Этот текст о цене», «Этот текст о качестве товара». Затем она оценивает, насколько каждое утверждение соответствует исходному тексту.
Процесс выглядит так:
- Берем текст.
- Задаем список возможных категорий.
- Для каждой категории формируем короткую гипотезу.
- Модель оценивает, насколько гипотеза соответствует тексту.
- Категория с самой высокой оценкой становится ответом.
Именно по такому принципу работает zero-shot classification в библиотеке Hugging Face Transformers. Список категорий при этом не нужно задавать во время обучения модели — его передают уже при обработке текста.
Результат зависит и от формулировки гипотезы. Например, для русского текста лучше использовать шаблон на русском языке: «Этот текст о {}». Английский шаблон вроде «This example is {}» может дать другой результат.
2. Через эмбеддинги — поиск самого близкого смысла
Здесь текст и названия категорий переводятся в наборы чисел — векторы. Они отражают смысл текста.
Например, есть отзыв:
«Курьер приехал на три дня позже».
Модель создает вектор этого текста, а затем сравнивает его с векторами категорий «доставка», «цена» и «качество товара». Если вектор текста оказался ближе всего к категории «доставка», ей и присваивается эта метка.
Такой подход обычно работает быстро и требует меньше вычислений. Однако он хуже учитывает сложный контекст, неоднозначность и тонкие различия между похожими категориями.
3. Через LLM и обычную инструкцию
С большими языковыми моделями задача становится еще проще. Модели достаточно дать текст, список категорий и инструкцию.
Например:
Определи категорию отзыва: доставка, цена или качество товара. Отзыв: «Заказ приехал на неделю позже обещанного срока».
Модель анализирует текст и отвечает: «доставка».
Такой способ называют zero-shot prompting: в запросе есть инструкция, но нет примеров правильных ответов.
Zero-shot, one-shot, few-shot и дообучение: в чем разница
|
Подход |
Что нужно от вас |
Гибкость |
Типичная точность |
Когда выбирать |
|---|---|---|---|---|
|
Zero-shot |
Названия и описания классов |
Максимальная |
Ниже, зависит от формулировок |
Быстрый старт, частая смена классов |
|
One-shot |
Один пример на класс |
Высокая |
Чуть выше |
Когда класс трудно описать словами |
|
Few-shot |
Несколько примеров на класс |
Высокая |
Заметно выше |
Баланс качества и скорости внедрения |
|
Fine-tuning |
Сотни и тысячи размеченных примеров |
Низкая (классы фиксированы) |
Обычно максимальная |
Стабильная задача с большим потоком |
|
Классический ML |
Размеченная выборка и обучение с нуля |
Низкая |
Зависит от данных |
Узкая задача без LLM |
Преимущества и ограничения
Преимущества
- Не нужна обучающая выборка: запуск занимает часы, а не недели.
- Набор классов меняется без переобучения.
- Подходит для редких и новых категорий, по которым нет данных.
- Один и тот же механизм работает для тем, эмоций, намерений и ситуаций.
Ограничения
- Качество ниже, чем у модели, дообученной на вашей выборке, особенно на узкой терминологии.
- Результат чувствителен к названиям меток и шаблону формулировки.
- Близкие классы («жалоба» и «негативный отзыв») модель путает.
- Возможны нестабильные ответы у LLM (зависят от температуры и версии модели).
- NLI-подход медленнее классических классификаторов: нужно оценивать каждую метку отдельно.
Zero-shot classification и GEO: где это работает на продвижение бренда
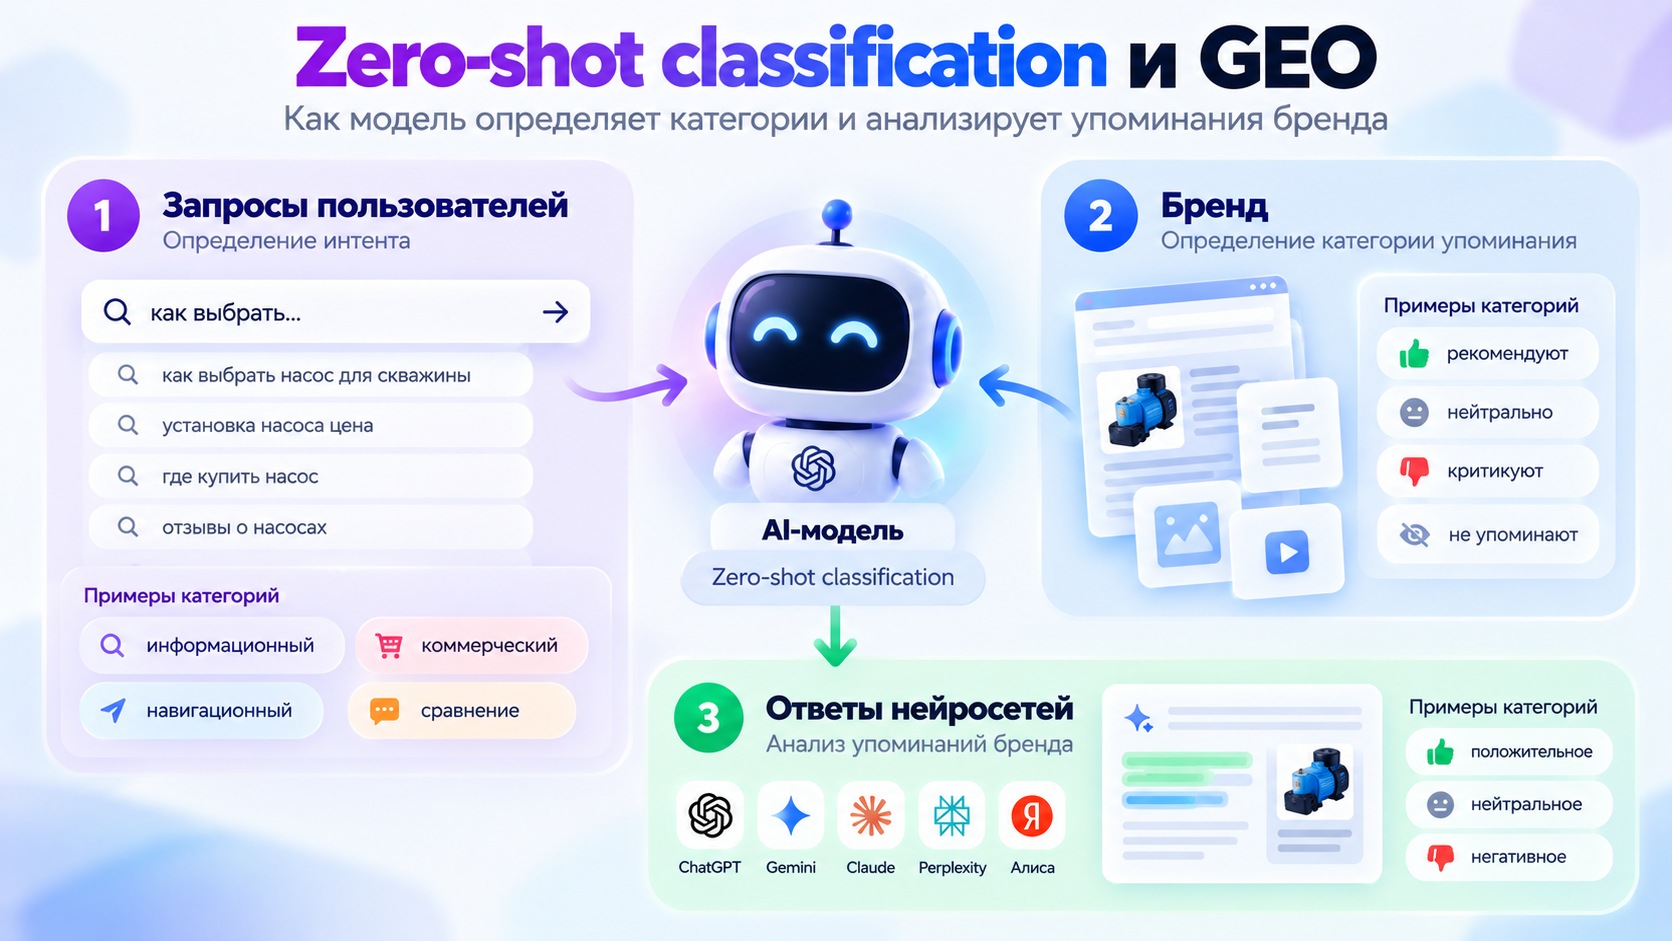
GEO (Generative Engine Optimization) — оптимизация бренда под ответы нейросетей. Zero-shot-классификация связана с ним с двух сторон: как вы анализируете ответы нейросетей и как нейросети относят ваш бренд к категориям.
Сценарий 1. Аналитика AI-видимости: разметка ответов нейросетей
Допустим, вы собрали сотни ответов ChatGPT, Claude и Perplexity на запросы вашей категории. Разбирать их вручную долго. Zero-shot-классификатор размечает ответы автоматически по нужным вам осям:
- упоминание: бренд упомянут / не упомянут;
- роль: рекомендован / один из списка / сравнивается / критикуется;
- тональность: позитивная / нейтральная / негативная;
- источник: официальный сайт / СМИ / отзывы / Википедия.
Так вы быстро получаете метрики: долю ответов с упоминанием, долю рекомендаций, соотношение позитива и негатива. Динамику можно сравнивать неделя к неделе.
Сценарий 2. Понять, как модель относит ваш бренд к категории
Нейросети отвечают на запрос вроде «какие компании используют LLM в юриспруденции», сопоставляя описание компаний со смыслом запроса. По сути это тоже работа с категориями, причем без обучения на примерах именно вашей ниши. Как правило, чем однозначнее контент бренда описывает, что он делает и для кого, тем вероятнее корректное попадание в нужную категорию. Контент с размытыми формулировками («мы работаем с ИИ») дает неоднозначную классификацию.
Сценарий 3. Классификация запросов пользователей (интентов)
Zero-shot помогает разметить список промптов целевой аудитории по намерениям: «выбрать поставщика», «сравнить решения», «узнать цену», «найти отзывы». После этого видно, по каким типам запросов бренд присутствует в ответах, а по каким нет, и под какие интенты не хватает контента.
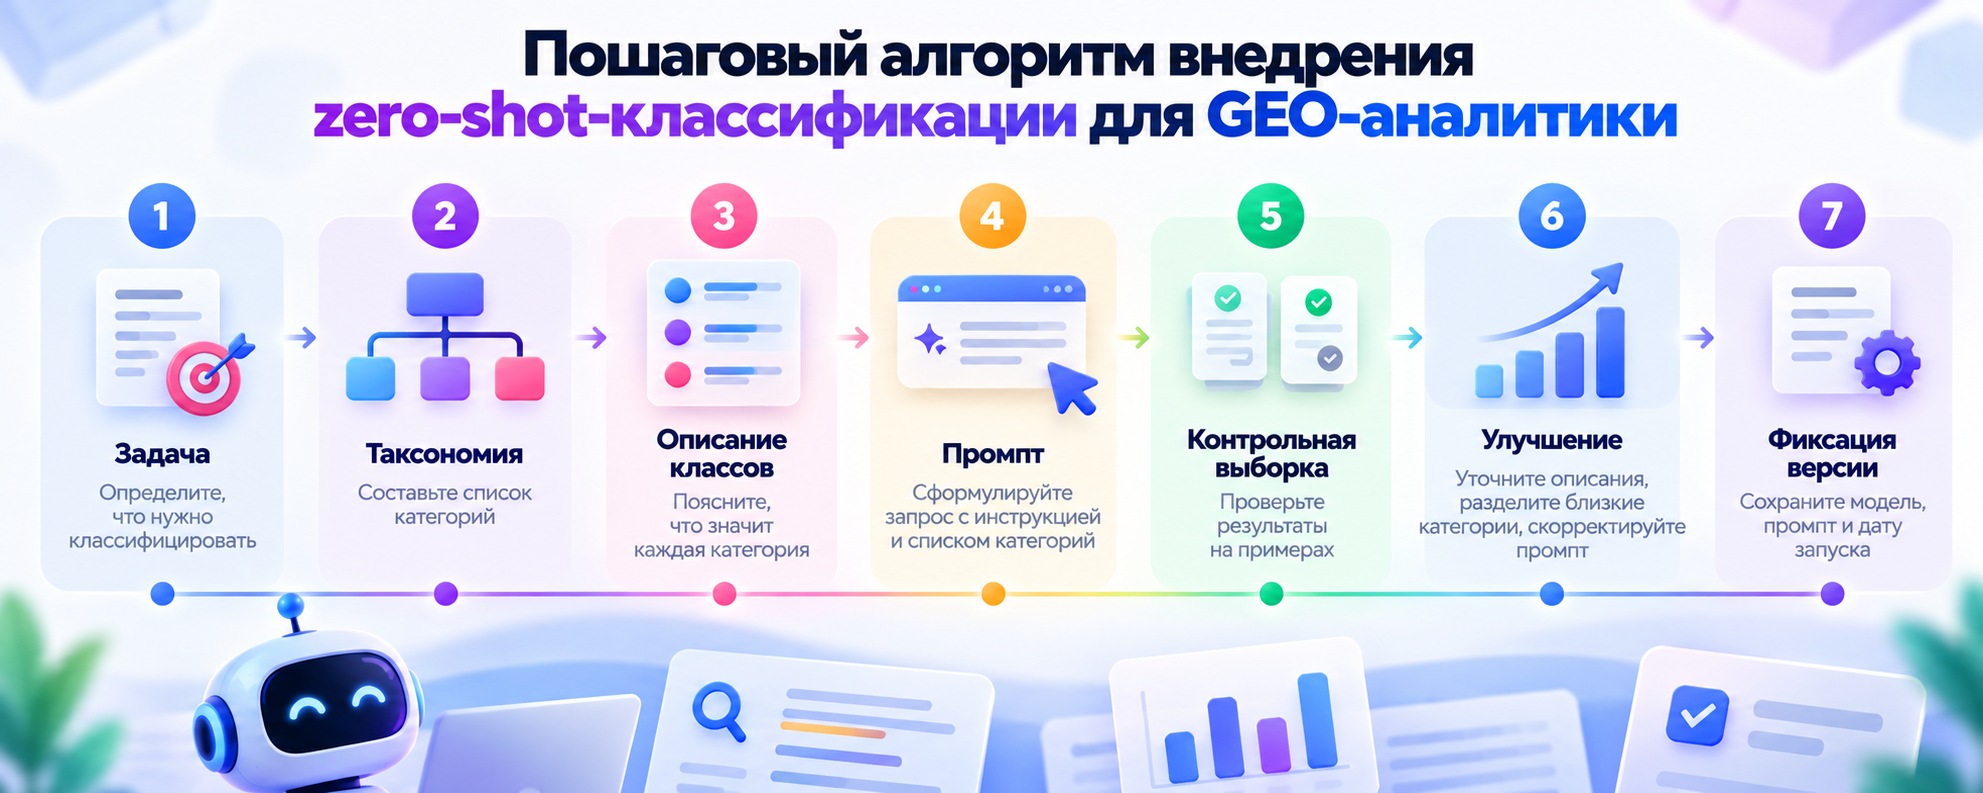
Пошаговый алгоритм внедрения zero-shot-классификации для GEO-аналитики
- Сформулируйте вопрос. Что вы хотите измерить: упоминания, тональность, роль бренда, интент запросов?
- Составьте таксономию. Классы должны быть взаимоисключающими и понятными. Лучше 4–6 четких меток, чем 15 пересекающихся.
- Опишите каждый класс. Одного названия мало. Добавьте определение и границу: чем «критика» отличается от «нейтрального сравнения».
- Напишите промпт с четким форматом вывода (JSON, фиксированный список значений).
- Проверьте на контрольной выборке. Разметьте вручную небольшой набор ответов и сравните с результатом модели. Посчитайте долю совпадений по каждому классу.
- Улучшите. Если есть стабильные ошибки, уточните определения классов или добавьте 2–3 примера на проблемный класс.
- Зафиксируйте версию модели и промпт, чтобы динамика метрик была сопоставимой во времени.
Частые ошибки при использовании zero-shot classification
- Пересекающиеся и расплывчатые метки. Классы «жалоба», «негатив» и «проблема» модель различает нестабильно. Объедините их или пропишите четкие критерии различия.
- Метки без определений. Название класса можно понять по-разному. Добавьте одно-два предложения с границами класса.
- Шаблон гипотезы на другом языке при NLI-подходе. Используйте шаблон на языке текста.
- Принимать результат без проверки. Zero-shot-модель может быть уверенно неправа. Сверяйтесь с ручной разметкой на контрольной выборке и регулярно пересматривайте ее.
- Не предусмотреть класс «другое / нет упоминания». Модель вынуждена выбрать из списка и навязывает неподходящую метку. Всегда добавляйте нейтральный класс.
- Менять модель или промпт без фиксации версии. В этом случае результаты разных запусков нельзя корректно сравнить: изменение метрик может быть связано с новой моделью или формулировкой запроса. Поэтому сохраняйте версию модели, текст промпта и дату каждого запуска.
- Использовать zero-shot там, где нужна высокая точность. Для критичных решений подходящий вариант — дообучение.
Чек-лист: как сделать контент и бренд однозначно «классифицируемым»
- На главной странице и в «О компании» четко написано, чем занимается компания и для какой аудитории.
- Категория и сегмент названы теми словами, которыми их называют пользователи в запросах.
- Кейсы содержат конкретные результаты и отрасль клиента.
- Продукты и услуги описаны отдельными страницами с уточняющими определениями.
- Есть глоссарий и FAQ, которые закрывают смежные категории и разводят похожие понятия.
- Упоминания в отраслевых изданиях формулируют специализацию бренда так же, как ваш сайт.
- Раз в месяц вы прогоняете страницы и ответы нейросетей через классификатор и смотрите, куда модель относит бренд.
Самые популярные термины