Кросс-верификация источников
Cross-source Verification, или кросс-верификация источников, — это метод проверки утверждения путем сопоставления сведений из нескольких источников. Его задача — найти подтверждения и противоречия, оценить происхождение данных и понять, насколько факту можно доверять.
Совпадение информации в нескольких источниках повышает надежность проверки, если эти источники действительно независимы друг от друга и сами заслуживают доверия. При этом количество публикаций само по себе ничего не доказывает: десять сайтов могут повторять одну и ту же ошибку из общего первоисточника.
В системах на базе больших языковых моделей (LLM) кросс-верификация может использоваться как один из подходов к проверке информации. Например, система может найти несколько документов, сопоставить их между собой и учесть расхождения перед формированием ответа. Такая логика встречается в отдельных RAG- и агентных архитектурах, однако не является обязательным этапом работы любой нейросети.
Для GEO этот принцип полезен с другой стороны. Бренду важно формировать согласованный и проверяемый информационный след — публиковать точные данные на собственном сайте и добиваться появления независимых упоминаний в источниках, к которым могут обращаться AI-поиск и нейросети.
Что такое Cross-source Verification простыми словами
Кросс-верификация — это проверка одного утверждения по нескольким источникам.
Допустим, нужно выяснить, действительно ли компания занимает первое место в отраслевом рейтинге. На сайте самой компании такая информация есть. Этого недостаточно для независимой проверки. Поэтому факт сверяют с самим рейтингом, публикацией его организатора, отраслевым СМИ или другими первичными и независимыми источниками.
При этом важно смотреть не на количество источников, где повторяется утверждение, а на происхождение информации.
Например:
- сайт компании сообщает: «в исследовании участвовали 10 000 клиентов»;
- пять СМИ перепечатывают эту же цифру из пресс-релиза;
- независимый исследовательский отчет подтверждает выборку и методику.
Формально информацию можно найти на нескольких страницах. Но независимых оснований для проверки фактически два: данные компании и исследовательский отчет.
Принцип кросс-верификации применяется в нескольких областях:
- В журналистике и фактчекинге информацию проверяют по нескольким независимым источникам и по возможности обращаются к первичным данным: официальным документам, отчетам, заявлениям организаций, исследованиям и другим материалам, где информация появилась изначально.
- В AI-системах cross-source verification может быть отдельным этапом проверки найденной информации. Система получает сведения из нескольких источников, сопоставляет их и выявляет совпадения или противоречия. Такой подход используется, например, в отдельных исследовательских фреймворках для автоматической проверки фактов.
- В GEO тот же принцип применим к информации о бренде. Чем проще подтвердить данные о компании по ее собственным материалам, первичным данным и независимым внешним публикациям, тем надежнее выглядит ее информационный след для пользователей и AI-систем, работающих с внешними источниками.
Дальше рассмотрим Cross-source Verification именно в контексте искусственного интеллекта, AI-поиска и продвижения брендов в ответах нейросетей.
Зачем кросс-верификация нужна системам на базе LLM
Большие языковые модели генерируют ответ на основе закономерностей, усвоенных при обучении. Они могут выдавать фактически неверную информацию, придумывать ссылки или уверенно отвечать там, где данных недостаточно. OpenAI также предупреждает, что высокая уверенность формулировки не означает фактическую надежность ответа.
Один из способов снизить такой риск — подключить внешние источники. Для этого часто используют RAG, веб-поиск, базы знаний или агентные системы.
Однако RAG и Cross-source Verification — разные понятия.
RAG получает дополнительную информацию из внешнего источника и передает ее модели вместе с запросом. При этом система может извлечь один документ и никак не сопоставлять его с другими. Кросс-верификация появляется тогда, когда найденные свидетельства действительно сравниваются между собой.
Исследования показывают, что подключение внешних данных способно снижать количество ошибок, однако результат сильно зависит от задачи и качества источников.
В исследовании Grace Sng, Yanming Zhang и Klaus Mueller сравнивали шесть LLM в задаче построения причинно-следственных связей. После добавления RAG средняя доля галлюцинаций в конкретном эксперименте снизилась с 50% до 13,9%. При этом моделям предоставлялся заранее подготовленный эталонный граф причинных связей, поэтому переносить эти показатели на любые RAG-системы нельзя.
Даже подключение внешних источников не гарантирует, что AI-система перестанет ошибаться. Это видно по исследованиям в разных областях.
В исследовании юридических AI-сервисов Lexis+ AI, Westlaw AI-Assisted Research и Ask Practical Law авторы проверили более 200 юридических запросов. Несмотря на использование RAG, системы выдавали ложную или вводящую в заблуждение информацию примерно в 17–33% ответов. Среди причин ошибок выделили проблемы при поиске нужных документов, использование неподходящих юридических источников и ошибки рассуждения модели.
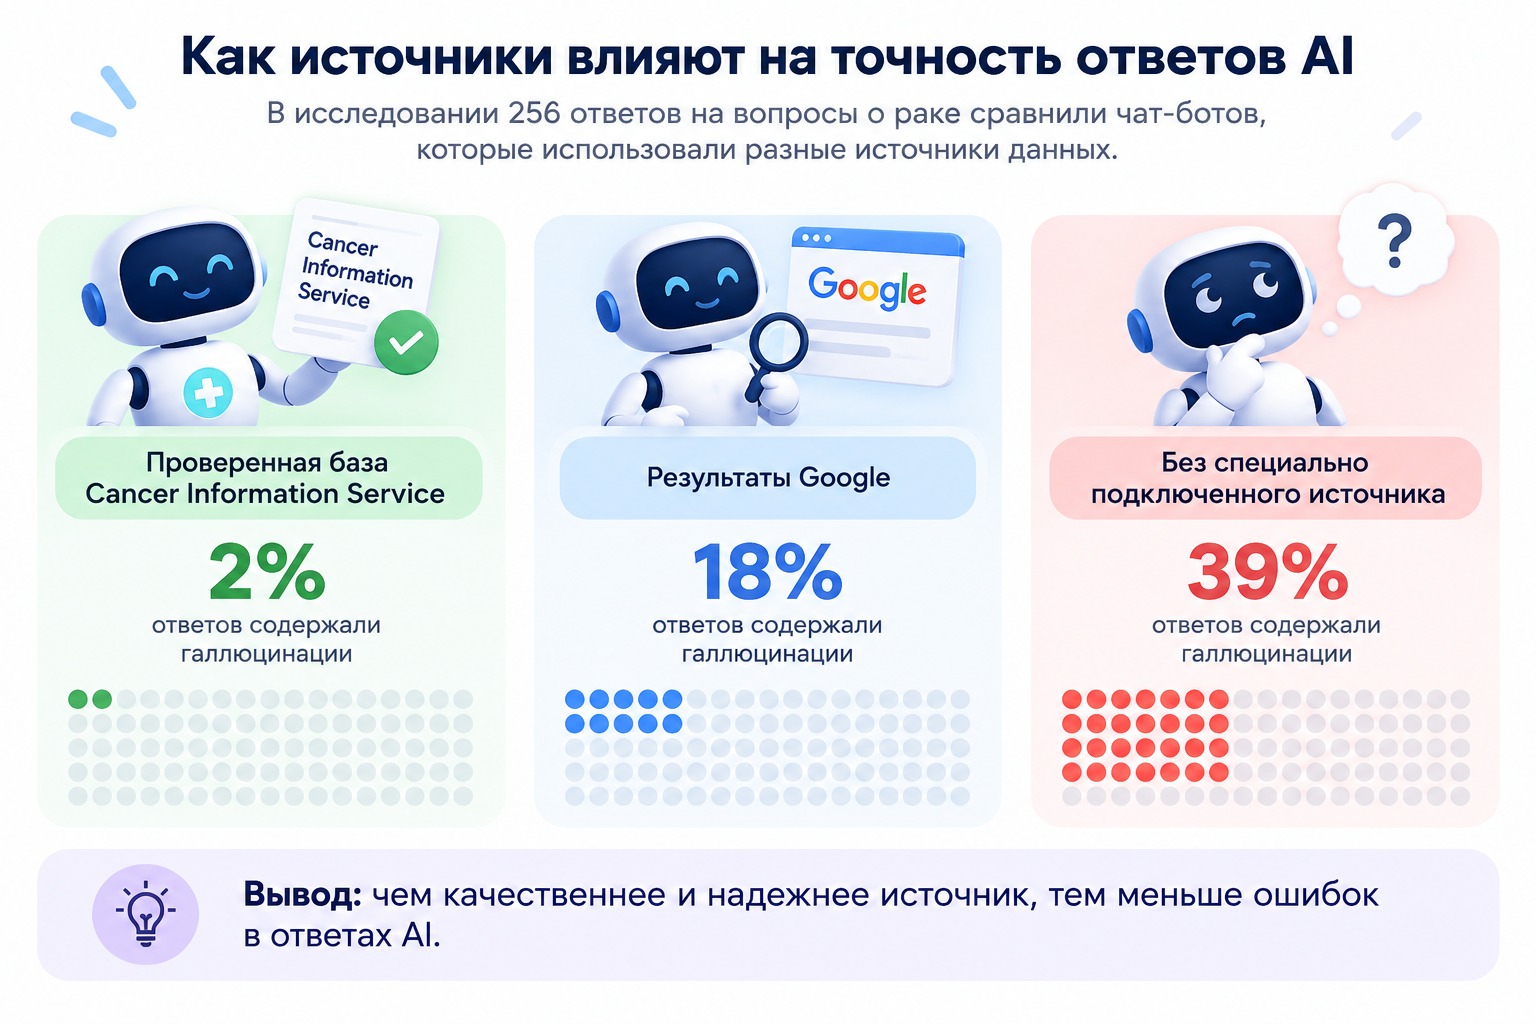
Похожий результат получили авторы исследования AI-чат-ботов для ответов на вопросы о раке. Они сравнили системы, которые использовали разные источники данных. В анализе 256 полученных ответов галлюцинации встречались примерно в 2% случаев у чат-ботов, обращавшихся к проверенной базе Cancer Information Service, в 18% — у систем, использовавших результаты Google, и в 39% — у обычных моделей без специально подключенного источника. Авторы связывают разницу с качеством данных, на которые опирается система.
Эти исследования показывают, что одного подключения поиска или RAG недостаточно. При проверке информации имеют значение качество и релевантность источников, их происхождение, актуальность и независимость друг от друга.
Как может работать кросс-верификация в AI-системах
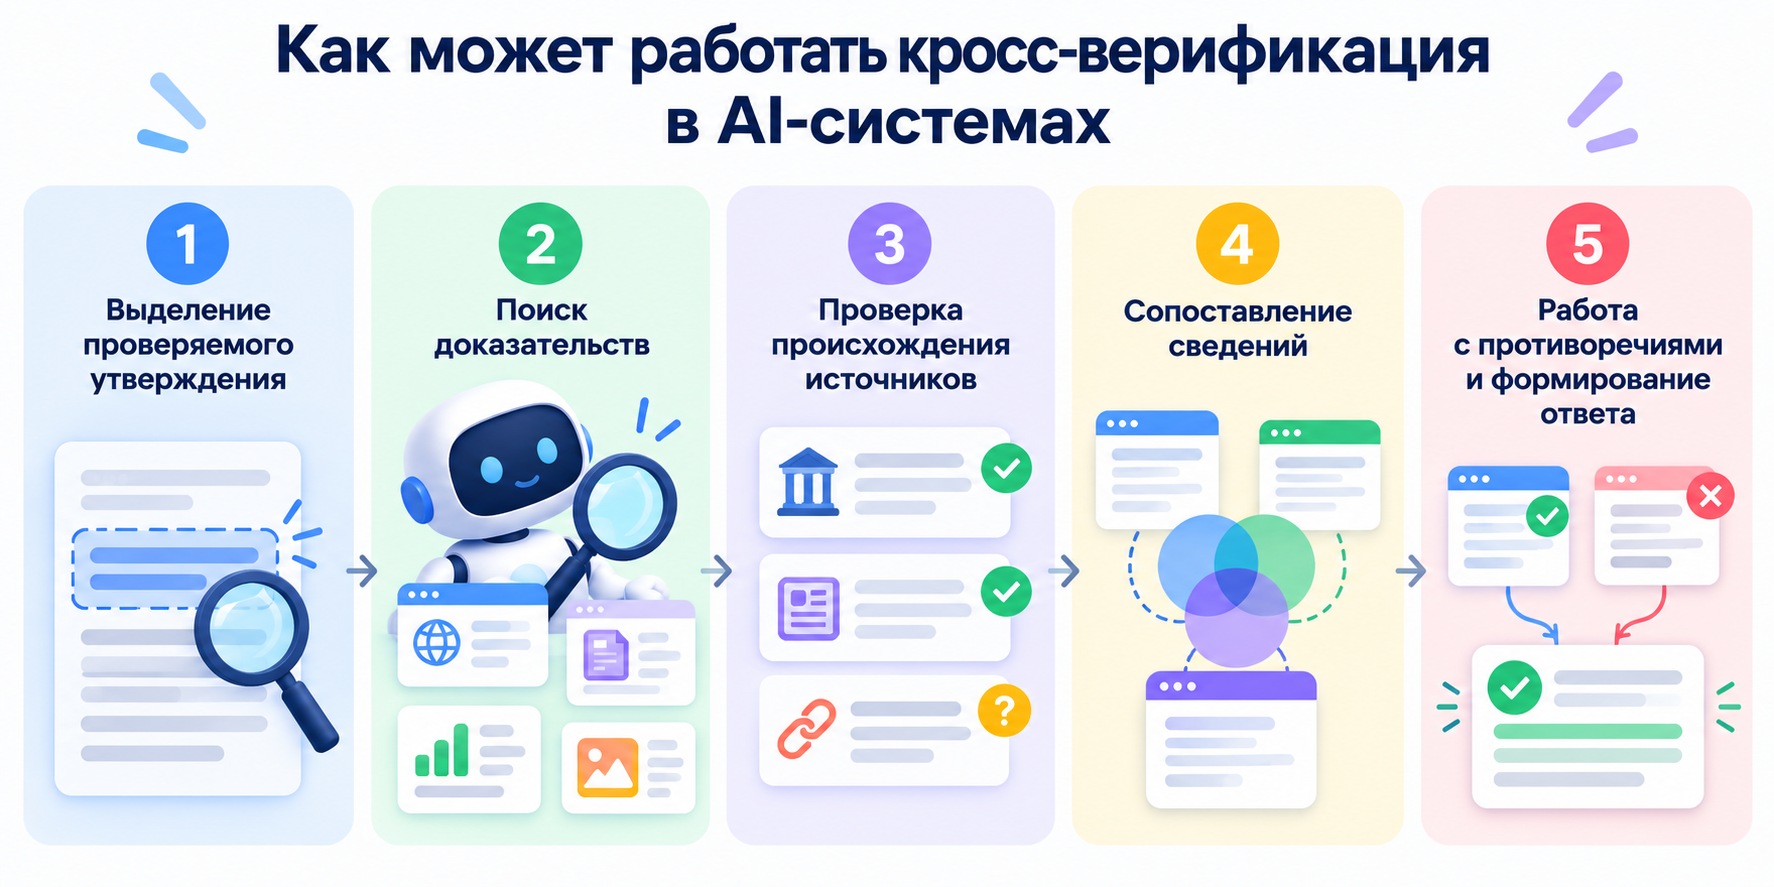
Единого технического стандарта Cross-source Verification для всех нейросетей нет. Реализация зависит от конкретного продукта и архитектуры. Один из возможных пайплайнов выглядит так.
1. Выделение проверяемого утверждения
Система определяет конкретный факт, который можно проверить:
- дату;
- число;
- характеристики;
- событие;
- причинно-следственную связь;
- утверждение о компании или человеке.
Например, из текста «Компания X обслуживает 2 млн клиентов и работает в 15 странах» можно выделить два отдельных утверждения, каждое из которых требует своей проверки.
2. Поиск доказательств
Дальше система ищет информацию в доступных источниках. В зависимости от архитектуры это могут быть:
- документы из внутренней базы знаний;
- сайты;
- официальные реестры;
- научные публикации;
- новостные материалы;
- базы данных;
- графы знаний.
RAG на этом этапе отвечает прежде всего за получение релевантного контекста. Сам факт получения нескольких документов еще не означает, что система выполнила кросс-верификацию.
3. Проверка происхождения источников
Следующий вопрос — действительно ли найденные источники независимы. Если три статьи ссылаются на один пресс-релиз компании, они подтверждают существование пресс-релиза, но не дают три независимых доказательства содержащихся в нем утверждений.
Поэтому при качественной проверке учитывают:
- первичный или вторичный это источник;
- откуда взялась исходная информация;
- не копируют ли материалы друг друга;
- кто отвечает за публикацию;
- когда данные были опубликованы;
- соответствует ли источник типу проверяемого факта.
Например, финансовые результаты компании разумнее проверять по официальной отчетности, а не по пересказу цифр в блоге.
4. Сопоставление сведений
Найденные данные сравниваются между собой:
- совпадают ли цифры;
- одинаковы ли даты;
- относится ли информация к одному периоду;
- одинаково ли определен показатель;
- есть ли существенные противоречия.
В некоторых исследовательских AI-системах проверка по нескольким источникам встроена в саму архитектуру. Например, HydraRAG — это исследовательская система для работы LLM с внешними данными, которая объединяет текстовые документы и графы знаний. Она сопоставляет сведения из разных источников, учитывает их надежность и проверяет, подтверждают ли они друг друга.
Похожий подход используется в AutoVerifier. В этой системе Cross-source Verification выделена в отдельный этап. Найденное утверждение сравнивается с независимыми исследованиями, опровержениями и другими материалами, чтобы определить, подтверждают ли источники друг друга или расходятся.
При этом HydraRAG и AutoVerifier — исследовательские разработки. По их устройству нельзя делать вывод, что ChatGPT, Gemini, Claude и другие AI-сервисы проверяют информацию таким же способом.
5. Работа с противоречиями и формирование ответа
Если данные совпадают, система получает больше оснований использовать утверждение.
Если источники расходятся, корректная стратегия зависит от ситуации. Система может:
- отдать предпочтение более подходящему первичному источнику;
- указать, что существуют разные данные;
- привести несколько значений с пояснением;
- запросить дополнительные сведения;
- отказаться от точного вывода, если доказательств недостаточно.
Именно работа с расхождениями отличает полноценную проверку от механического сбора нескольких ссылок.
Уровни кросс-верификации
|
Тип |
Кто выполняет |
Скорость |
Особенности |
Где применяется |
|---|---|---|---|---|
|
Ручная |
Редактор, фактчекер, аналитик, эксперт |
Низкая |
Позволяет учитывать контекст, качество методологии и происхождение данных |
Журналистика, исследования, юридический и редакционный аудит |
|
Автоматизированная |
Поиск, retrieval-система, LLM и правила проверки |
Высокая |
Качество зависит от источников и логики сопоставления; обычный RAG может вообще не выполнять cross-source verification |
Чат-боты, корпоративные ассистенты, AI-поиск |
|
Агентная |
Один или несколько AI-агентов |
От секунд до минут |
Агенты могут разделять поиск, проверку и анализ противоречий; использование нескольких агентов само по себе не гарантирует более точный результат |
Исследовательские системы, аналитика, специализированные AI-продукты |
Агентный подход удобен в сложных задачах, потому что поиск и проверку можно разделить на несколько этапов. Например, один агент ищет первичные источники, второй проверяет вторичные публикации, третий сопоставляет результаты.
При этом увеличение числа моделей или агентов не означает автоматического роста точности. Ошибка одного агента может распространяться дальше по цепочке, поэтому качество зависит от всей архитектуры проверки.
Cross-source Verification и смежные понятия: в чем разница
|
Понятие |
Что означает |
Чем отличается от Cross-source Verification |
|---|---|---|
|
Фактчекинг |
Полный процесс проверки утверждения |
Кросс-верификация — один из возможных методов фактчекинга. Проверка может также включать анализ первичных документов, расчеты, интервью и экспертную оценку |
|
RAG |
Получение внешнего контекста перед генерацией ответа |
RAG может получить данные из одного источника и не сравнивать документы между собой |
|
Grounding |
Опора ответа модели на предоставленные данные или источники |
Ответ может быть grounded в одном документе; кросс-верификация предполагает сопоставление сведений |
|
E-E-A-T |
Концепция Google, связанная с опытом, экспертностью, авторитетностью и достоверностью контента |
Это не технический механизм кросс-верификации и не отдельный фактор ранжирования |
|
Показатель присутствия бренда или источника в ответах AI-систем |
Цитируемость показывает результат наблюдения, а не способ проверки фактов |
|
|
Характеристика надежности и репутации источника |
Авторитетность можно учитывать при кросс-верификации наряду с актуальностью, релевантностью и независимостью |
Особенно важно не смешивать Cross-source Verification с E-E-A-T. Google прямо указывает, что E-E-A-T сам по себе не является отдельным фактором. Это концепция, которую используют для описания характеристик полезного и заслуживающего доверия контента. Специалисты оценивают результаты поиска по соответствующим критериям, но их оценки не поступают в алгоритмы ранжирования напрямую.
Cross-source Verification в GEO: какое значение имеет для бренда
В GEO кросс-верификацию можно рассматривать как работу с информацией о бренде так, чтобы ее было легко проверить по разным источникам.
Если данные о компании совпадают на собственном сайте, в отраслевых публикациях, исследованиях, каталогах и других релевантных источниках, AI-системам проще находить и сопоставлять эту информацию при формировании ответа.
Особенно это заметно в AI-поиске, который может работать сразу с несколькими страницами. Например, Google указывает, что AI Overviews и AI Mode используют подход query fan-out: система разбивает исходный запрос на несколько связанных подтем, выполняет дополнительные поисковые запросы и собирает информацию с разных страниц.
Поэтому в GEO важно следить, чтобы сведения о бренде были:
- понятными и конкретными;
- актуальными;
- согласованными между разными площадками;
- доступными для поисковых систем;
- подтвержденными первичными данными, если речь идет о цифрах, исследованиях или кейсах;
- представлены на релевантных внешних площадках.
Так у AI-систем появляется больше качественных источников, из которых они могут получить и проверить информацию о бренде.
Почему внешние упоминания важны для кросс-верификации в GEO
Связь между внешним присутствием бренда и GEO можно увидеть и в данных «Пиксель Тулс». В «Рейтинге GEO-факторов» 9 экспертов оценивали факторы, связанные с видимостью брендов в ответах нейросетей.
Среди высоко оцененных факторов есть те, которые связаны с присутствием информации о бренде в разных источниках:
- упоминания бренда в крупных онлайн-СМИ — 75,6%;
- количество упоминаний бренда в интернете — 74,4%;
- текстовые упоминания на UGC-площадках — 73,3%;
- публикация собственных исследований, статистики и отчетов — 70%.
Для Cross-source Verification эти факторы особенно интересны. Собственные исследования и данные дают исходную информацию о компании, а публикации в СМИ, отраслевых материалах и на других площадках создают дополнительные источники, с которыми AI-система может работать при поиске ответа.
При этом оценки в рейтинге не означают, что несколько упоминаний автоматически заставят нейросеть считать факт достоверным или повысят видимость бренда на определенный процент. Они показывают, что специалисты связывают присутствие бренда во внешних источниках с его видимостью в AI-системах.
Дополнительно определить, с какими площадками работают нейросети, помогает «Рейтинг источников нейросетей». В нем собраны миллионы источников из более чем 100 тысяч AI-ответов. По рейтингу можно посмотреть, какие сайты и типы площадок чаще используются нейросетями как источники информации.
Для GEO это дает практический ориентир: важно не распространять один и тот же текст как можно шире, а добиваться присутствия бренда в релевантных источниках, где информация о компании может быть найдена и сопоставлена с другими данными.
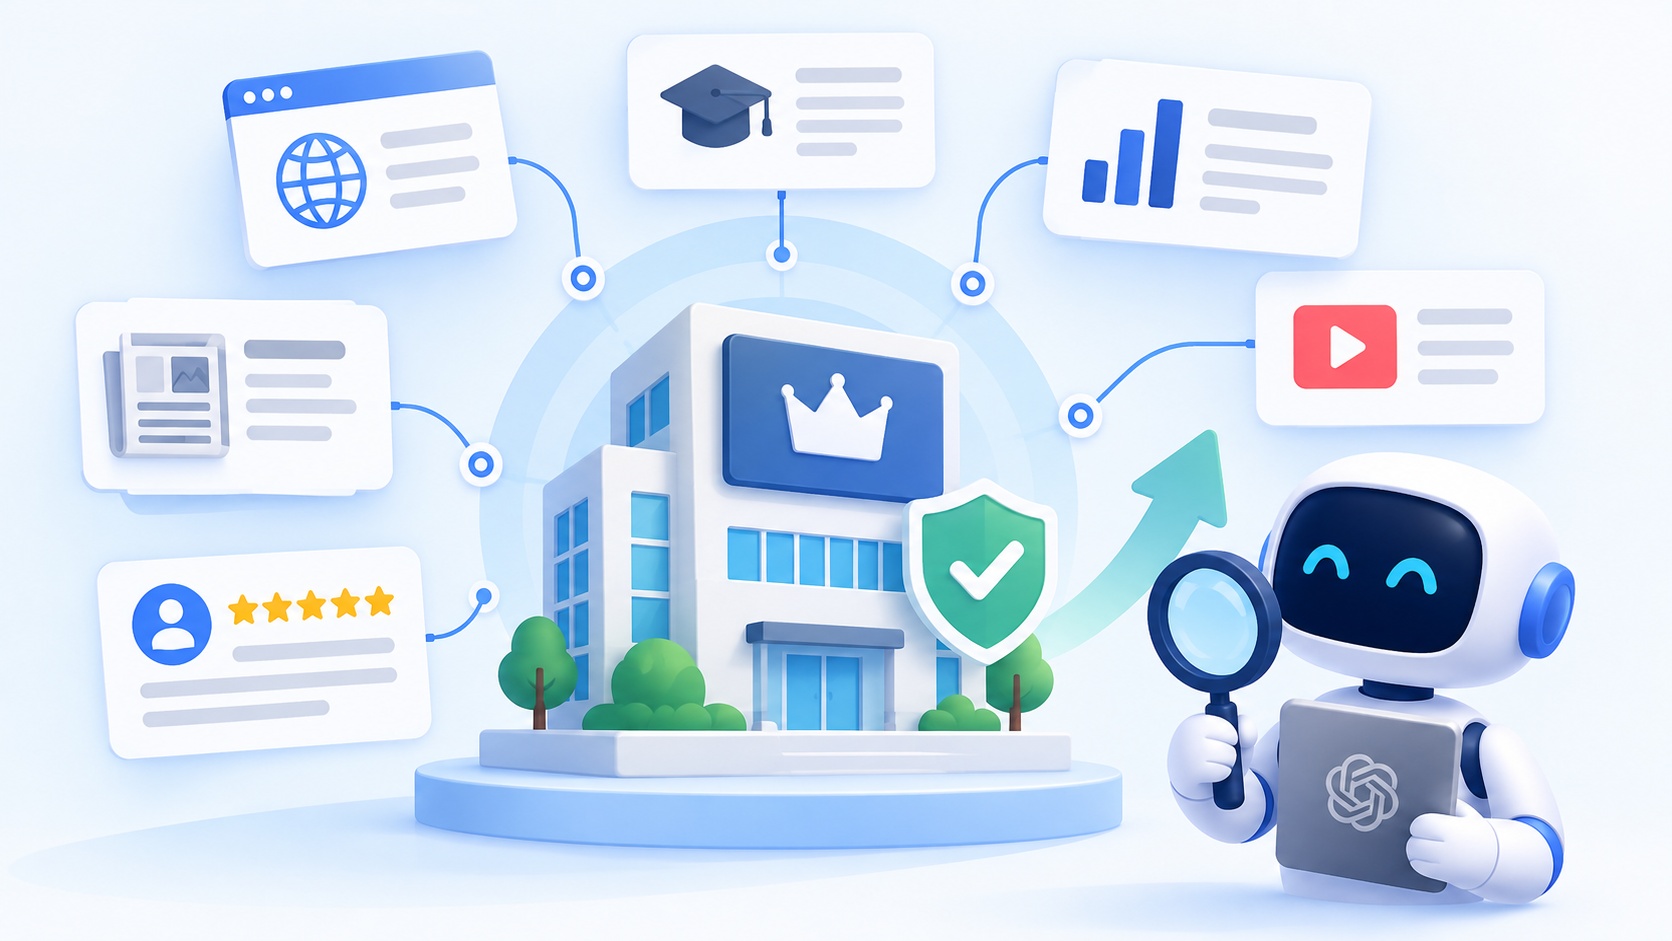
Пример Cross-source Verification в GEO
Возьмем вымышленный сервис «Финтра CRM».
На своем сайте компания публикует кейс:
«После внедрения Финтра CRM среднее время обработки заявки у компании N сократилось с 3 дней до 20 минут».
Чтобы утверждение можно было проверить, в кейсе должны быть понятны:
- клиент;
- период измерения;
- что считается временем обработки;
- показатели до и после внедрения;
- источник данных.
Дальше возможны два сценария.
Сценарий 1. Есть независимые подтверждения
Компания N сама публикует результаты внедрения на своем сайте. Отраслевое издание изучает кейс, получает комментарий клиента и указывает те же показатели. В обзоре CRM есть ссылка на исходное исследование.
В этом случае поисковая или AI-система потенциально может найти несколько материалов с понятным происхождением данных и сопоставить их.
Сценарий 2. Есть только публикации
«Финтра CRM» рассылает пресс-релиз, после чего десять сайтов публикуют одну и ту же цифру без самостоятельной проверки. Количество URL выросло, но исходный источник утверждения остался прежним. Поэтому говорить о десяти независимых подтверждениях нельзя. Именно это различие особенно важно для GEO: распространение информации и независимое подтверждение — разные задачи.
Чек-лист: как сделать информацию о бренде более проверяемой для AI
1. Поддерживайте единые фактические данные на своих ресурсах. Дата основания компании, характеристики продукта, цены, результаты исследований и другие проверяемые сведения не должны противоречить друг другу на разных страницах.
2. Не стремитесь к дословному повторению одной формулировки. Для проверки важнее совпадение факта и понятное происхождение данных. Массовое копирование одного пресс-релиза не создает независимых подтверждений.
3. Публикуйте первичные данные. Для исследований и кейсов указывайте методику, период, выборку, источник цифр и критерии расчета. Так другим площадкам проще проверить информацию и корректно на нее сослаться.
4. Работайте с релевантными внешними источниками. Отраслевые СМИ, рейтинги, каталоги, исследования, клиентские кейсы и профессиональные площадки могут расширять информационный след бренда. Ценность зависит от контекста и качества материала.
5. Отделяйте независимые публикации от перепечаток. Если десять материалов восходят к одной новости компании, учитывайте их как распространение одного первичного сообщения.
6. Следите за актуальностью данных. Старые цены, количество клиентов, состав продукта или устаревшая статистика создают противоречия между источниками. Для меняющихся показателей указывайте дату.
7. Используйте понятную структуру страниц. Таблицы, списки, определения, подписи к показателям и явные ссылки на источники помогают пользователю и автоматическим системам понять материал.
8. Применяйте schema.org там, где разметка соответствует содержанию страницы и поддерживается поисковыми системами. Например, Organization или Product помогают структурировать отдельные типы данных. Однако специальной schema.org-разметки для попадания в Google AI Overviews или AI Mode не требуется.
9. Проверяйте AI-видимость в нескольких системах. Смотрите, упоминается ли бренд, какие характеристики ему приписываются и на какие источники ссылается модель.
10. Не воспринимайте совпадение ответов разных нейросетей как доказательство кросс-верификации. Разные модели могут использовать похожие исходные материалы или повторять одну ошибку. Мониторинг показывает стабильность информационного поля, но не раскрывает внутренний процесс проверки конкретной модели.
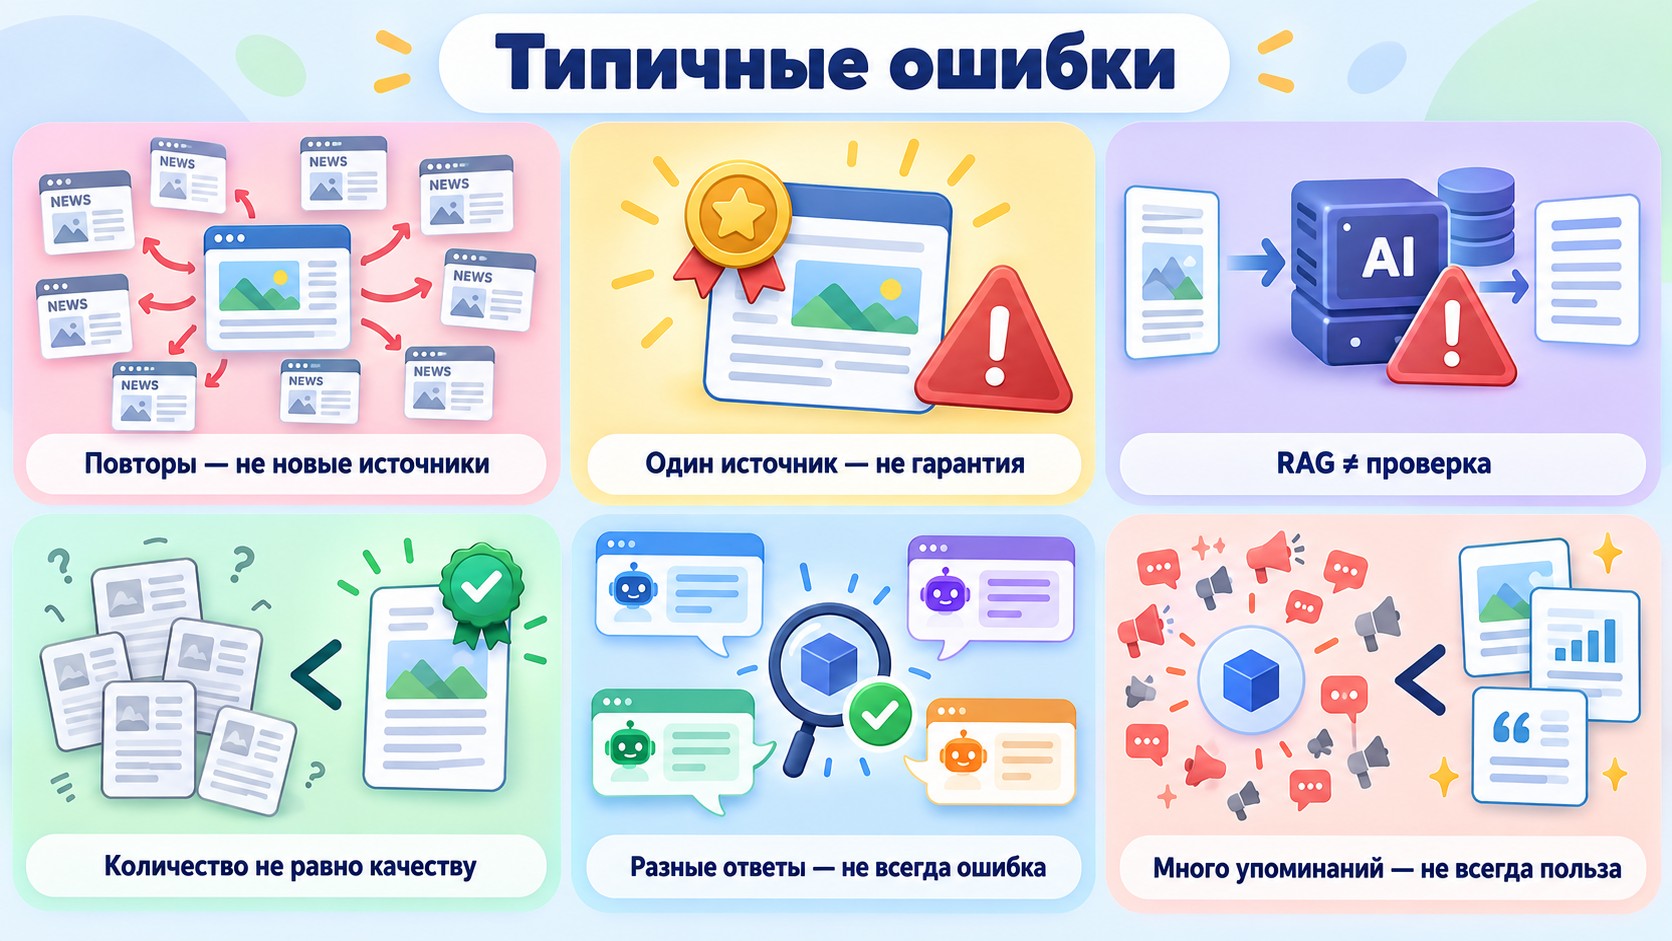
Типичные ошибки
Считать любое повторение факта независимым подтверждением
Если публикации копируют одну исходную новость, источник информации остается один.
Что делать: искать происхождение утверждения и по возможности первичные данные.
Полагаться на один источник только потому, что он известный
Репутация площадки имеет значение, но даже авторитетный источник может ошибиться или опираться на вторичные данные.
Что делать: для значимых утверждений проверять первоисточник и дополнительные независимые свидетельства.
Считать RAG автоматической кросс-верификацией
RAG отвечает за получение внешнего контекста. Он может работать с одним документом и вообще не выполнять сравнение источников.
Что делать: при разработке собственной AI-системы отдельно предусматривать анализ происхождения документов, сопоставление утверждений и обработку противоречий.
Оценивать качество проверки только по количеству источников
5 ненадежных публикаций могут дать хуже результат, чем один хорошо документированный первичный источник.
Что делать: учитывать тип источника, актуальность, методологию и независимость.
Считать разные ответы нейросетей признаком ошибки в данных о бренде
ChatGPT, Gemini, Claude и другие AI-системы могут использовать разные источники и по-разному формировать ответы. Поэтому один и тот же факт о бренде они иногда описывают по-разному, даже если исходные данные верны.
Что делать: сравнить, в чем именно расходятся ответы, и проверить, на какие источники опирается каждая система.
Пытаться решить GEO только массовыми упоминаниями
Большое количество публикаций без полезного контекста не равно качественному информационному присутствию.
Что делать: работать с релевантными площадками, предоставлять проверяемые данные и создавать материалы, которые дают полноценный ответ на пользовательский запрос.
Преимущества и ограничения Cross-source Verification
Преимущества
- Помогает выявлять ошибки и противоречия. Сопоставление нескольких независимых источников показывает, где сведения расходятся.
- Снижает зависимость от одного документа. Ошибка в одном источнике с меньшей вероятностью останется незамеченной.
- Полезна при работе с RAG и AI-поиском. Проверка нескольких документов позволяет оценивать ответ глубже, чем простая генерация по одному фрагменту.
- Повышает прозрачность проверки. Пользователь может увидеть, на каких данных основан вывод.
- Полезна для GEO-стратегии. Работа с первичными данными, актуальностью и внешними упоминаниями формирует более понятное информационное поле вокруг бренда.
Ограничения
- Несколько источников могут повторять одну ошибку. Количество страниц нельзя приравнивать к количеству независимых подтверждений.
- Источники могут конфликтовать. Это особенно характерно для быстро меняющихся данных, прогнозов и спорных тем.
- Первичный источник иногда важнее нескольких вторичных. Например, действующую ставку налога разумнее проверять по официальному нормативному документу, а не искать три статьи с одинаковой цифрой.
- Автоматическая проверка тоже ошибается. Retrieval может найти нерелевантный документ, а LLM — неверно его интерпретировать.
- Результат зависит от доступности информации. Если первичные данные закрыты, не индексируются или не опубликованы, проверить утверждение сложнее.