RAG
RAG (Retrieval-Augmented Generation) — подход, при котором система перед генерацией ответа получает релевантную информацию из внешнего источника и передает ее языковой модели как дополнительный контекст. Источником может быть база документов компании, поисковый индекс, API или интернет. Такой подход помогает использовать актуальные или специализированные сведения без переобучения самой языковой модели.
Термин Retrieval-Augmented Generation закрепился после работы Patrick Lewis и соавторов «Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks», представленной на NeurIPS 2020. В этой работе авторы объединили параметрическую память генеративной модели с внешней непараметрической памятью — индексом документов, из которого система извлекала релевантные фрагменты.
RAG применяется в корпоративных AI-системах, поиске по внутренним знаниям и продуктах, где генеративная модель получает данные из внешних источников. Google официально использует термин RAG при описании генеративных функций Search: компания определяет его как способ опоры на внешние данные, при котором системы Search получают релевантные актуальные страницы из поискового индекса и используют сведения из них при формировании ответа.
Что такое RAG простыми словами
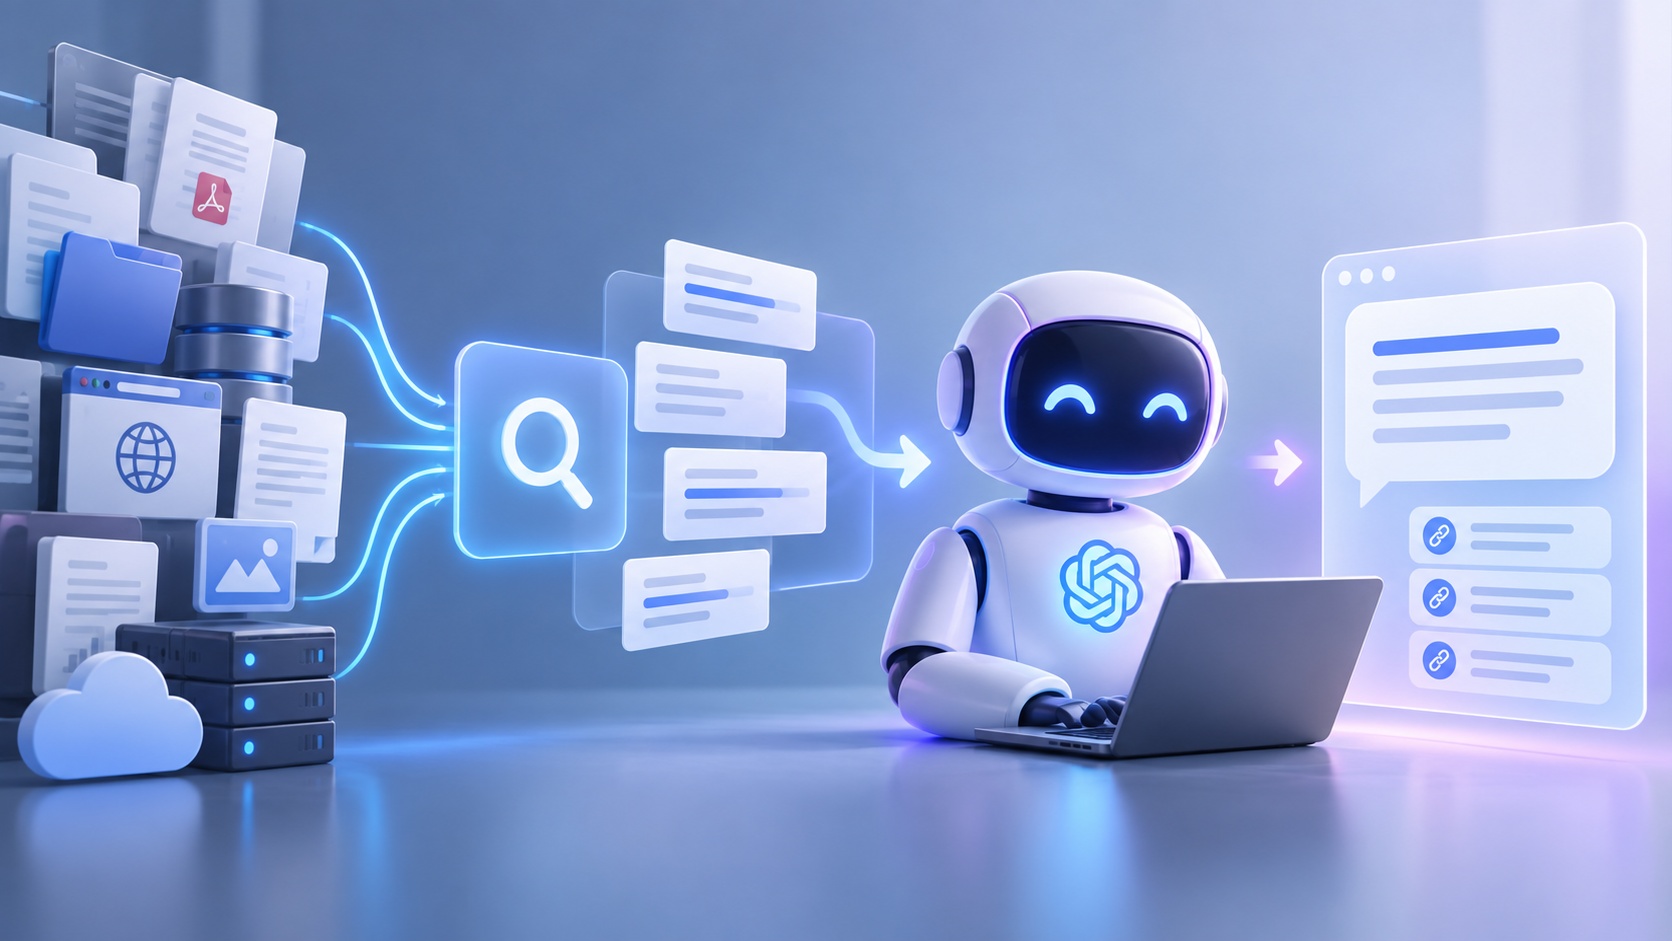
Упрощенно RAG можно представить как работу эксперта, который сначала ищет нужные документы, а затем отвечает на вопрос с учетом найденной информации.
В классической схеме есть три этапа:
- Retrieval — извлечение. Система ищет данные, подходящие к запросу пользователя.
- Augmentation — дополнение. Найденные сведения добавляются к входным данным модели.
- Generation — генерация. LLM формирует ответ с учетом вопроса и полученного контекста.
RAG при этом не означает, что модель перестает использовать знания, полученные при обучении. Входной контекст дополняет ее параметрические знания и дает ей сведения, которых могло не быть в обучающей выборке или которые могли измениться позднее.
Зачем нужен RAG
У языковой модели без внешних источников есть несколько ограничений:
- Знания могут устаревать. Модель обучается на определенном наборе данных, поэтому более свежая информация может быть ей недоступна. Подключение поиска дает доступ к актуальным веб-источникам.
- Модель может ошибаться. LLM способна выдавать правдоподобные, но неверные факты, даты, цитаты или ссылки. Такие ошибки называют галлюцинациями.
RAG помогает снизить риск таких ошибок: система сначала находит подходящие данные, а затем передает их модели как основу для ответа. При необходимости ответ может сопровождаться ссылками на исходные материалы. При этом RAG не гарантирует полную точность: если система нашла нерелевантные, неполные или устаревшие документы, итоговый ответ тоже может содержать ошибки.
Как работает RAG
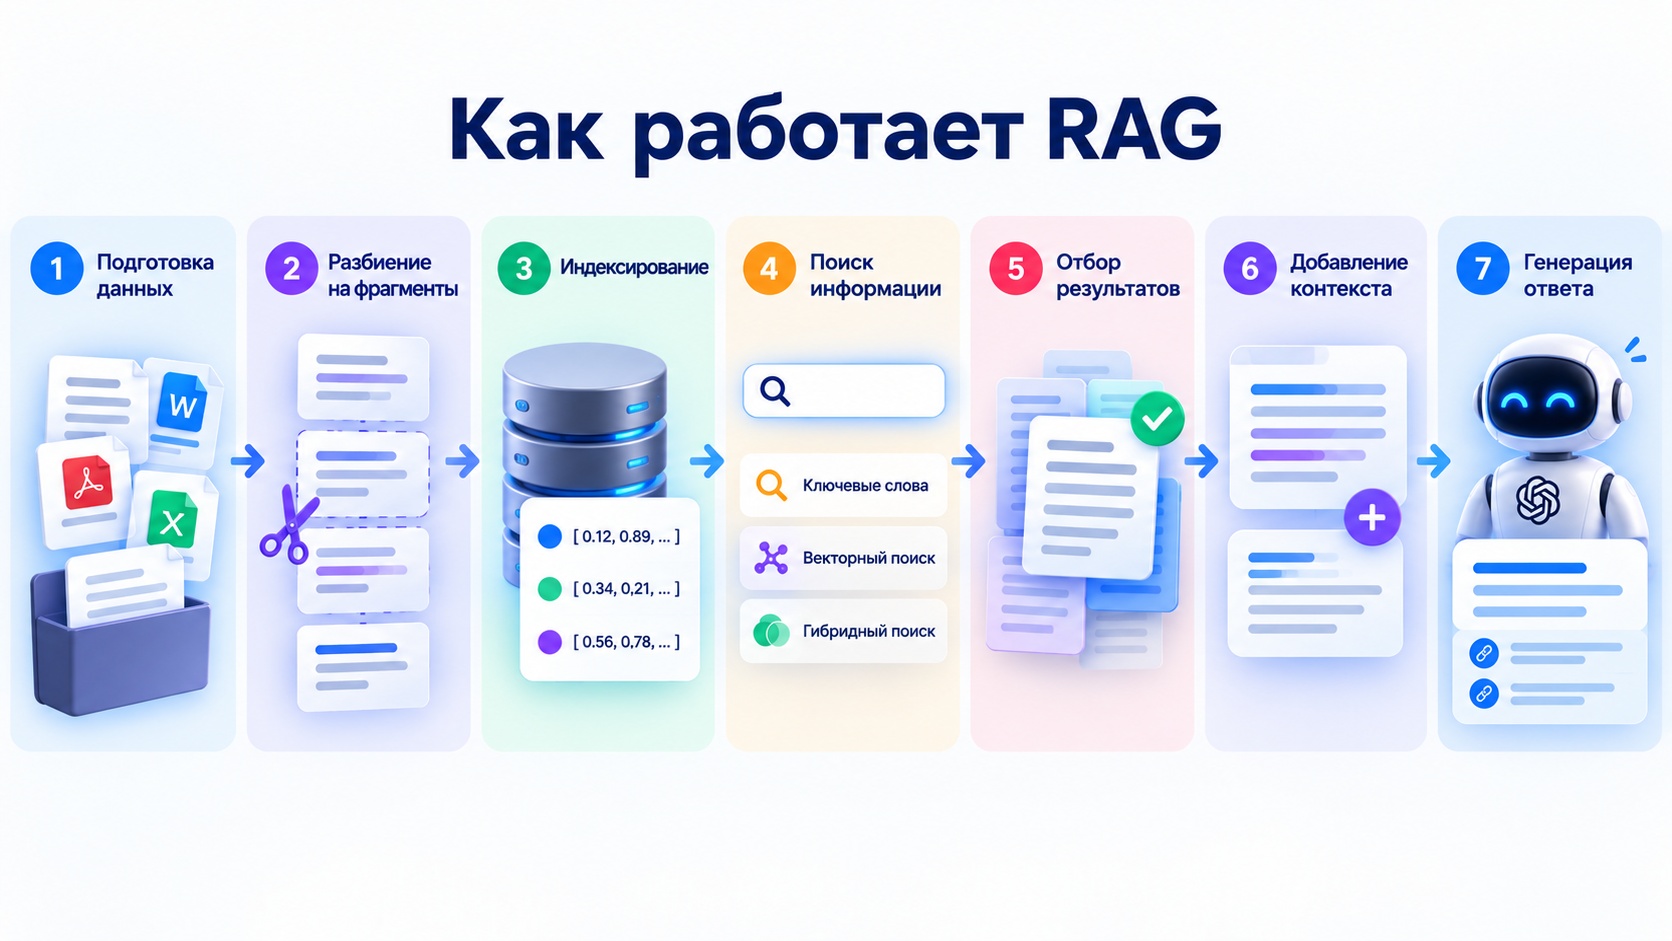
1. Подготовка данныхСначала система подготавливает материалы, по которым будет искать информацию. Документы очищают, разбивают на небольшие фрагменты и добавляют в поисковый индекс.
Хранить данные можно по-разному. RAG не требует обязательного использования векторной базы. Система может искать информацию по ключевым словам, по смыслу или сочетать несколько способов поиска.
2. Retrieval — поиск информацииКогда пользователь задает вопрос, система ищет фрагменты, которые лучше всего ему соответствуют. Для этого могут использоваться разные методы. Например, обычный поиск находит точные слова и фразы, а векторный сравнивает смысл запроса и документов с помощью числовых представлений текста — embeddings.
Часто применяют гибридный поиск, который сочетает несколько подходов. Например, он может одновременно учитывать точные совпадения слов и смысловую близость.
Похожий подход использует Perplexity: в своей поисковой инфраструктуре сервис сочетает сигналы, связанные с текстовыми совпадениями, смыслом запроса.
3. Augmentation — добавление найденной информацииПосле поиска подходящие фрагменты передаются языковой модели вместе с вопросом пользователя. Они становятся дополнительной информацией, на которую модель может опираться при подготовке ответа. Также системе можно задать правила: использовать только найденные источники, добавлять ссылки, сообщать, если данных недостаточно, или отвечать в заданном формате.
4. Generation — формирование ответаНа последнем этапе языковая модель формирует ответ с учетом найденных материалов. Если система сохраняет информацию об источниках, рядом с ответом могут отображаться ссылки на них. При этом сам факт использования RAG не гарантирует, что ответ и ссылки будут без ошибок. Результат зависит от того, какие документы нашла система, насколько правильно она их отобрала и как настроена генерация.
Какие архитектуры RAG используются
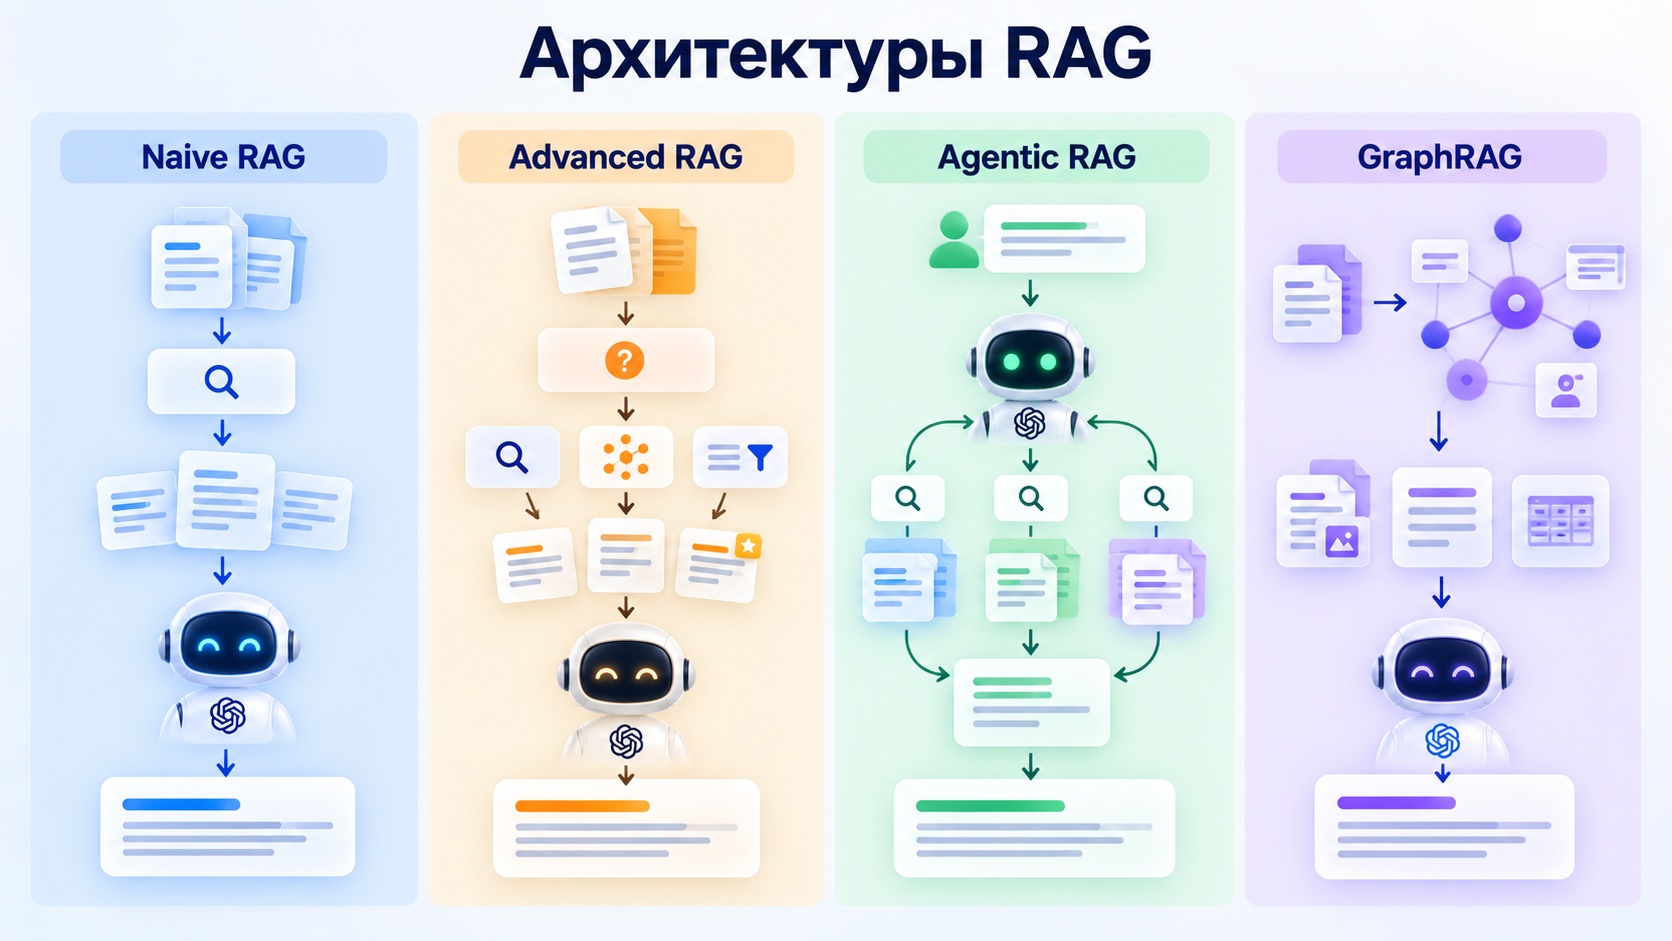
У RAG нет одной универсальной схемы. Архитектуру выбирают в зависимости от объема данных, сложности запросов и того, насколько точно система должна находить информацию:
- Naive RAG — самый простой вариант. Система получает запрос, находит подходящие материалы, добавляет их к вопросу и передает все это языковой модели для подготовки ответа.
- Advanced RAG — более сложная схема. Перед поиском система может уточнять или преобразовывать запрос, а после — фильтровать и дополнительно сортировать найденные материалы. Это помогает выбрать более подходящие данные.
- Agentic RAG — подход, при котором модель сама участвует в организации поиска. Например, сложный вопрос может быть разбит на несколько более простых запросов. Система выполняет их отдельно, собирает результаты, затем использует их для подготовки общего ответа.
- GraphRAG — подход, который использует граф знаний. Система выделяет в документах сущности, например компании, людей, продукты или события, и устанавливает связи между ними. Это помогает отвечать на вопросы, где нужно учитывать информацию сразу из нескольких частей большого набора данных.
Эти варианты можно рассматривать как разные способы построения RAG-системы. Выбор зависит от того, какие данные используются и какие задачи должна решать система.
RAG и fine-tuning: в чем разница
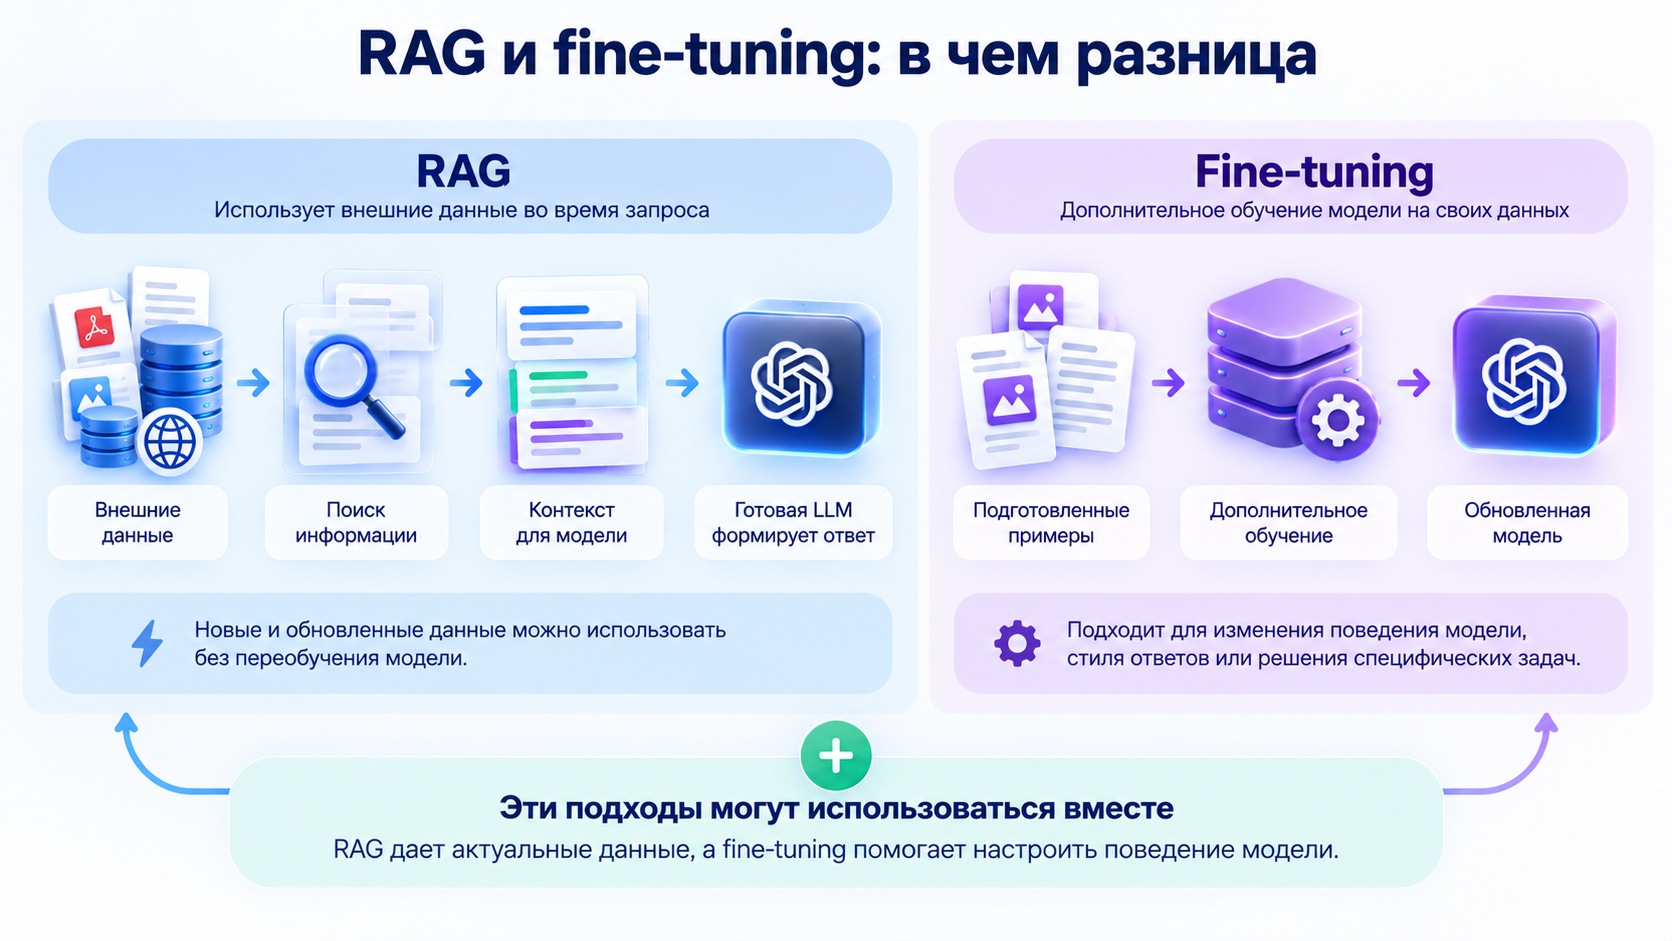
RAG и fine-tuning работают по-разному.
- При RAG модель получает нужные данные во время самого запроса. Например, система может найти информацию во внутренних документах компании или в поисковом индексе и передать ее модели для подготовки ответа. Переобучать модель для этого не требуется.
- При fine-tuning модель дополнительно обучают на подготовленном наборе примеров. Такой подход используют, когда нужно скорректировать ее поведение, стиль ответов или выполнение определенной задачи.
Поэтому RAG подходит для работы с частными или регулярно обновляемыми данными, а fine-tuning — для настройки поведения модели. Эти подходы могут использоваться вместе.
Где применяется RAG
Корпоративные базы знанийRAG помогает AI-ассистенту работать с внутренними документами компании: инструкциями, регламентами, базами данных и другими материалами. Если информация обновилась, достаточно обновить источник — переобучать языковую модель не требуется.
Поиск по специализированной информацииRAG используют там, где ответ должен опираться на определенный набор документов. Например, на техническую документацию, нормативные материалы, каталоги, внутренние инструкции или профессиональные базы знаний.
Генеративный поискRAG применяется и в генеративном поиске. Например, Google Search может находить актуальные страницы в поисковом индексе и использовать информацию из них при подготовке ответа. Для сложных вопросов система также может создавать несколько связанных поисковых запросов, чтобы собрать больше данных.
ChatGPT Search тоже ищет информацию в интернете и может добавлять к ответам ссылки на источники. При этом OpenAI не описывает всю систему ChatGPT Search как классическую RAG-архитектуру.
Perplexity также сочетает поиск информации в интернете с генерацией ответа. В своей технической документации компания описывает поиск, который учитывает как совпадения по словам, так и смысловую близость.
Поэтому генеративный поиск шире классической схемы RAG: разные сервисы могут использовать собственные способы поиска, отбора источников, подготовки ответа.
Преимущества
RAG дает несколько практических преимуществ:
- к модели подключаются актуальные данные без повторного обучения;
- система может работать с частными или специализированными базами знаний;
- retrieved content может служить основой для ссылок, проверки ответа;
- объем доступной информации не ограничивается сведениями, содержащимися в параметрах модели.
При работе с конфиденциальной информацией нужно отдельно проверять, как выбранный AI-сервис хранит, обрабатывает переданные данные. RAG не требует обучать модель на этих сведениях, но правила их хранения, использования и защиты зависят от конкретного провайдера.
Ограничения
RAG помогает модели опираться на внешние данные, но не гарантирует, что ответ всегда будет точным.
Если система нашла неподходящие, неполные или устаревшие материалы, модель может использовать их и допустить ошибку. На качество также влияют то, как документы подготовлены и разбиты на фрагменты, насколько хорошо работает поиск, сколько информации помещается в контекст.
Для работы RAG нужна дополнительная инфраструктура: источник данных, поисковый индекс или сервис поиска, механизм обновления информации и настройка доступа. Если используется векторный поиск, системе также нужны векторные представления текста.
Актуальность данных тоже нужно контролировать. Если документ изменился, а поисковый индекс не обновили, модель может получить старую версию информации и использовать ее.
Частые ошибки при внедрении RAG
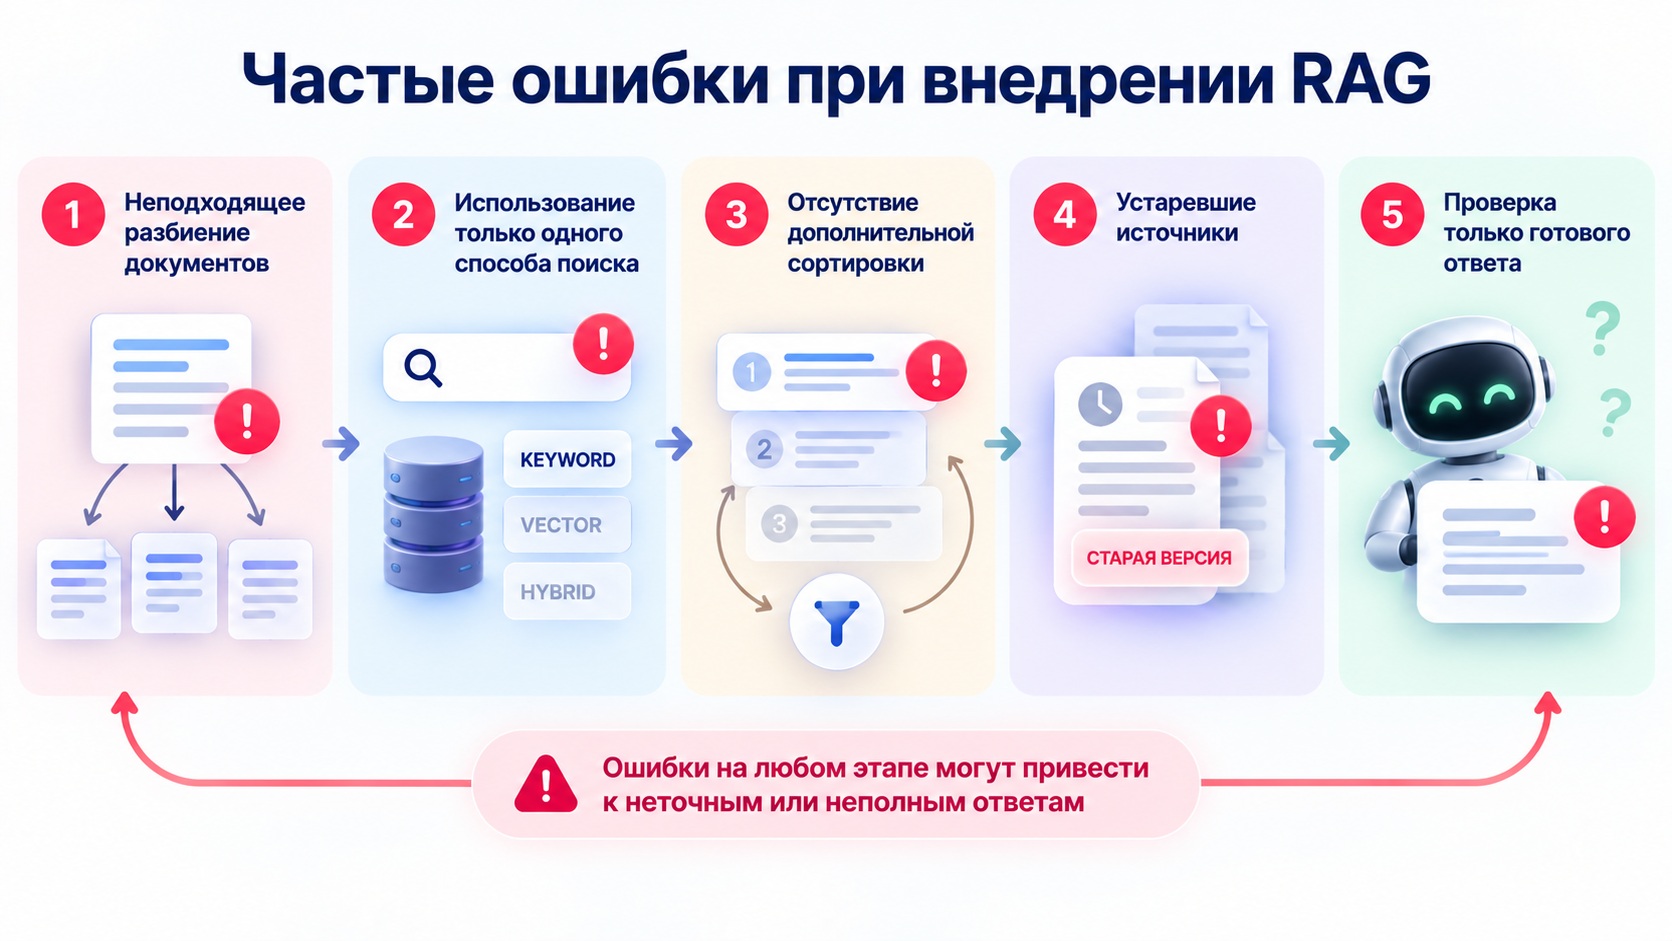
Неподходящее разбиение документовПеред поиском документы обычно делят на небольшие фрагменты. Если они слишком большие, система может получать много лишней информации. Если слишком маленькие — теряется контекст. Единого подходящего размера для всех RAG-систем нет, поэтому разбиение нужно проверять на реальных документах и типичных запросах пользователей.
Использование только одного способа поискаВекторный поиск хорошо находит материалы, близкие по смыслу. Но при поиске точных названий, кодов, артикулов или специальных терминов лучше может работать обычный полнотекстовый поиск. Поэтому в RAG-системах часто используют гибридный поиск, который сочетает несколько методов.
Отсутствие дополнительной сортировки результатовПервичный поиск может найти много подходящих фрагментов, но самые полезные из них окажутся не в начале списка. Поэтому найденные материалы часто дополнительно фильтруют и сортируют по релевантности перед передачей языковой модели.
Устаревшие источникиЕсли документ обновился, а поисковый индекс остался прежним, модель может получить старую версию информации. Поэтому данные в RAG-системе нужно регулярно обновлять и повторно индексировать.
Проверка только готового ответаЕсли оценивать только итоговый ответ, сложно понять причину ошибки. Проблема может возникнуть уже на этапе поиска: система не нашла нужный документ или выбрала неподходящий фрагмент.
Поэтому отдельно проверяют качество поиска и то, насколько итоговый ответ соответствует найденным источникам. Для этого используются специальные метрики и инструменты оценки RAG-систем.
Как RAG связан с GEO
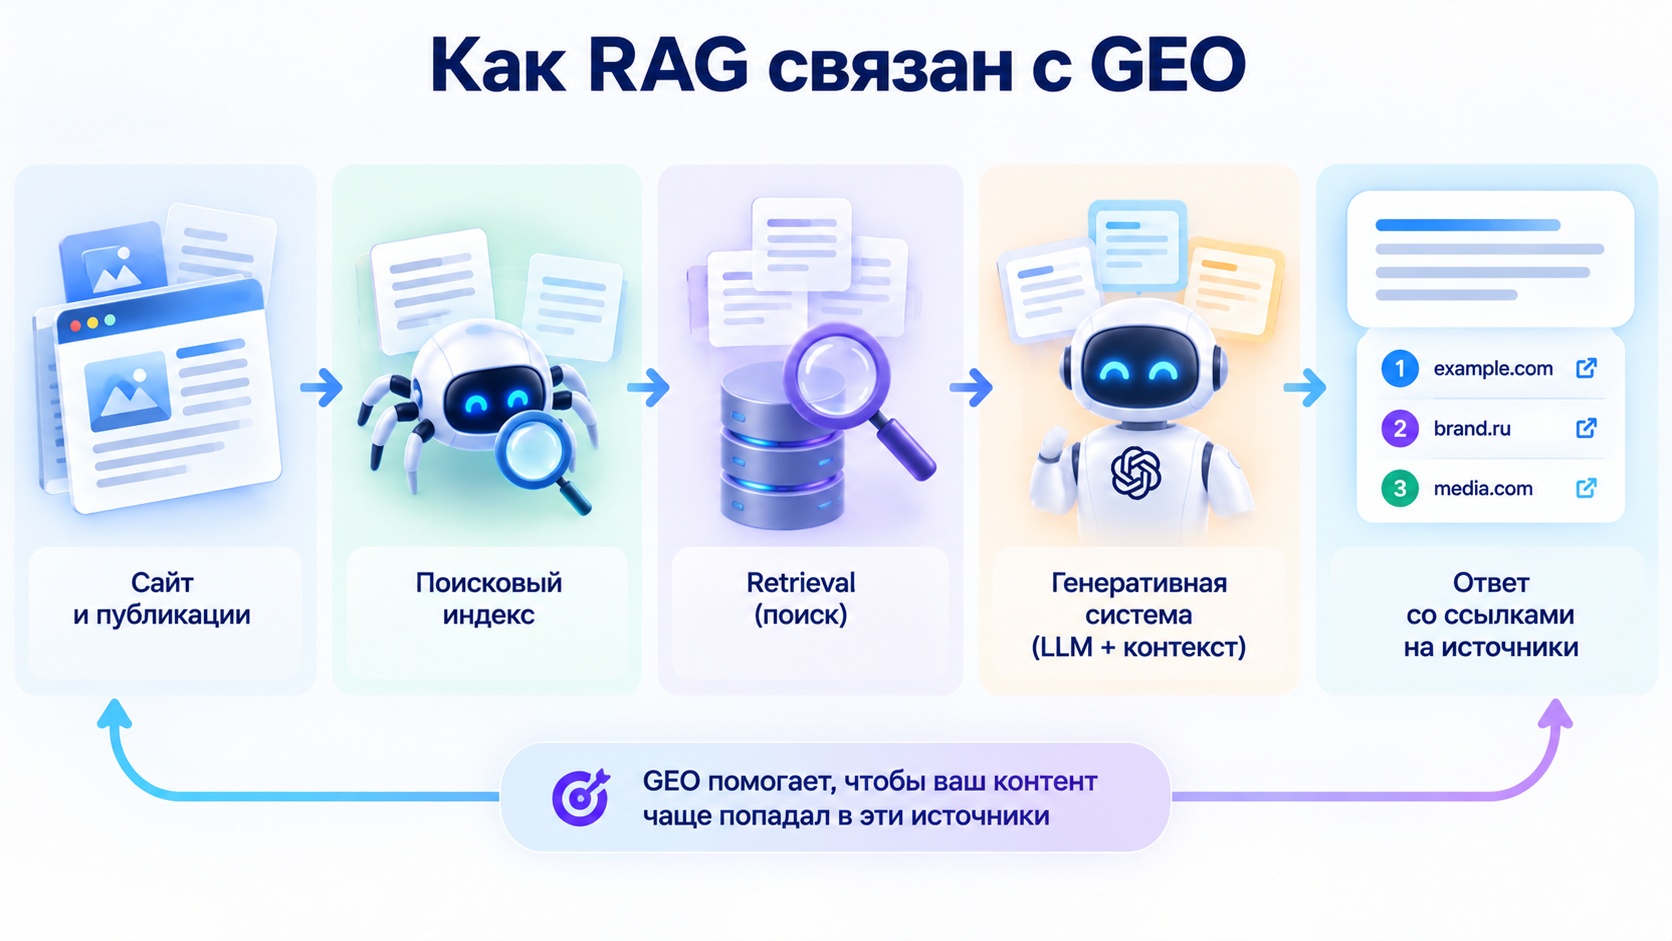
GEO (Generative Engine Optimization) — комплекс мероприятий, направленных на то, чтобы бренд и его материалы чаще появлялись в ответах генеративных систем.
Связь GEO с RAG особенно заметна в генеративном поиске. Прежде чем использовать страницу сайта при подготовке ответа, поисковая система должна ее найти, получить содержимое и определить, подходит ли оно к запросу пользователя.
В генеративных функциях Google Search для поиска подходящих материалов используются страницы из поискового индекса. Чтобы страница могла появиться среди источников ответа, она должна быть доступна для индексации и соответствовать обычным требованиям Google Search.
Похожий принцип действует в ChatGPT Search. Чтобы страницы сайта могли находиться через поиск и использоваться в ответах со ссылками, сайт не должен блокировать OAI-SearchBot. При этом сам доступ поискового робота не гарантирует, что конкретная страница появится в ответе.
Perplexity также использует собственный веб-индекс и сочетает несколько способов поиска информации. При отборе материалов учитываются разные характеристики документов, в том числе их актуальность и авторитетность источника.
Для GEO из этого следует практический вывод: чтобы материал чаще попадал в поле зрения генеративных систем, он должен быть доступен для поиска, хорошо раскрывать тему и содержать понятную, актуальную и проверяемую информацию.
RAG в трех тезисах
1. RAG дает языковой модели доступ к внешней информации во время запроса. Это могут быть документы, базы данных, поисковый индекс или другие источники. Переобучать модель для обновления этих данных не нужно.
2. RAG помогает сделать ответы точнее, но не исключает ошибок. Если система нашла неподходящий или устаревший источник, модель может использовать неверную информацию.
3. Для GEO особенно важно, какие источники генеративная система находит и использует. При этом бренд может попасть в ответ через свой сайт, публикации в СМИ, рейтинги, каталоги и другие внешние площадки.
Самые популярные термины