XAI (Explainable AI)
XAI (Explainable Artificial Intelligence, объяснимый искусственный интеллект) — направление в AI, которое объединяет методы для объяснения результатов работы моделей. С их помощью специалист может исследовать, почему система выдала определенный прогноз, решение или ответ, какие входные данные связаны с результатом и насколько устойчиво такое объяснение.
В NIST объяснимость рассматривается через способность AI-системы предоставлять причины или свидетельства для полученного результата. Национальный институт стандартов и технологий США (NIST) выделяет четыре принципа XAI: система должна объяснять свои результаты, делать это понятным для пользователя, давать объяснение, соответствующее ее реальной работе, и учитывать границы собственных знаний.
Например, если AI-система считает кредитную заявку рискованной, XAI помогает показать, какие данные повлияли на этот вывод: уровень дохода, размер долгов, история платежей или другие факторы.
В случае генеративного ИИ анализируют, от чего зависит AI-ответ: как сформулирован запрос, какие данные и источники получила модель и как меняется ответ при изменении этих условий.
Зачем нужен XAI
Современные AI-модели часто работают как сложные системы, в которых человеку трудно проследить путь от входных данных до итогового результата. Пользователь видит, что он передал модели и какой ответ получил, но не всегда понимает, почему система пришла именно к такому выводу.
Для решения этой задачи и развивалось направление XAI. Например, агентство DARPA запускало программу Explainable Artificial Intelligence, цель которой — сделать работу AI-систем более понятной человеку.
На практике XAI используют, чтобы:
- понять, почему модель приняла конкретное решение;
- определить, какие данные сильнее повлияли на результат;
- найти ошибки или нежелательные зависимости в работе модели;
- проверить, насколько стабильно система ведет себя в похожих ситуациях;
- упростить аудит и контроль AI-систем;
- дать человеку больше информации для оценки результата.
NIST также относит объяснимость и интерпретируемость к характеристикам надежных AI-систем: они помогают специалистам проверять, отслеживать и документировать работу моделей.
Как работает Explainable AI
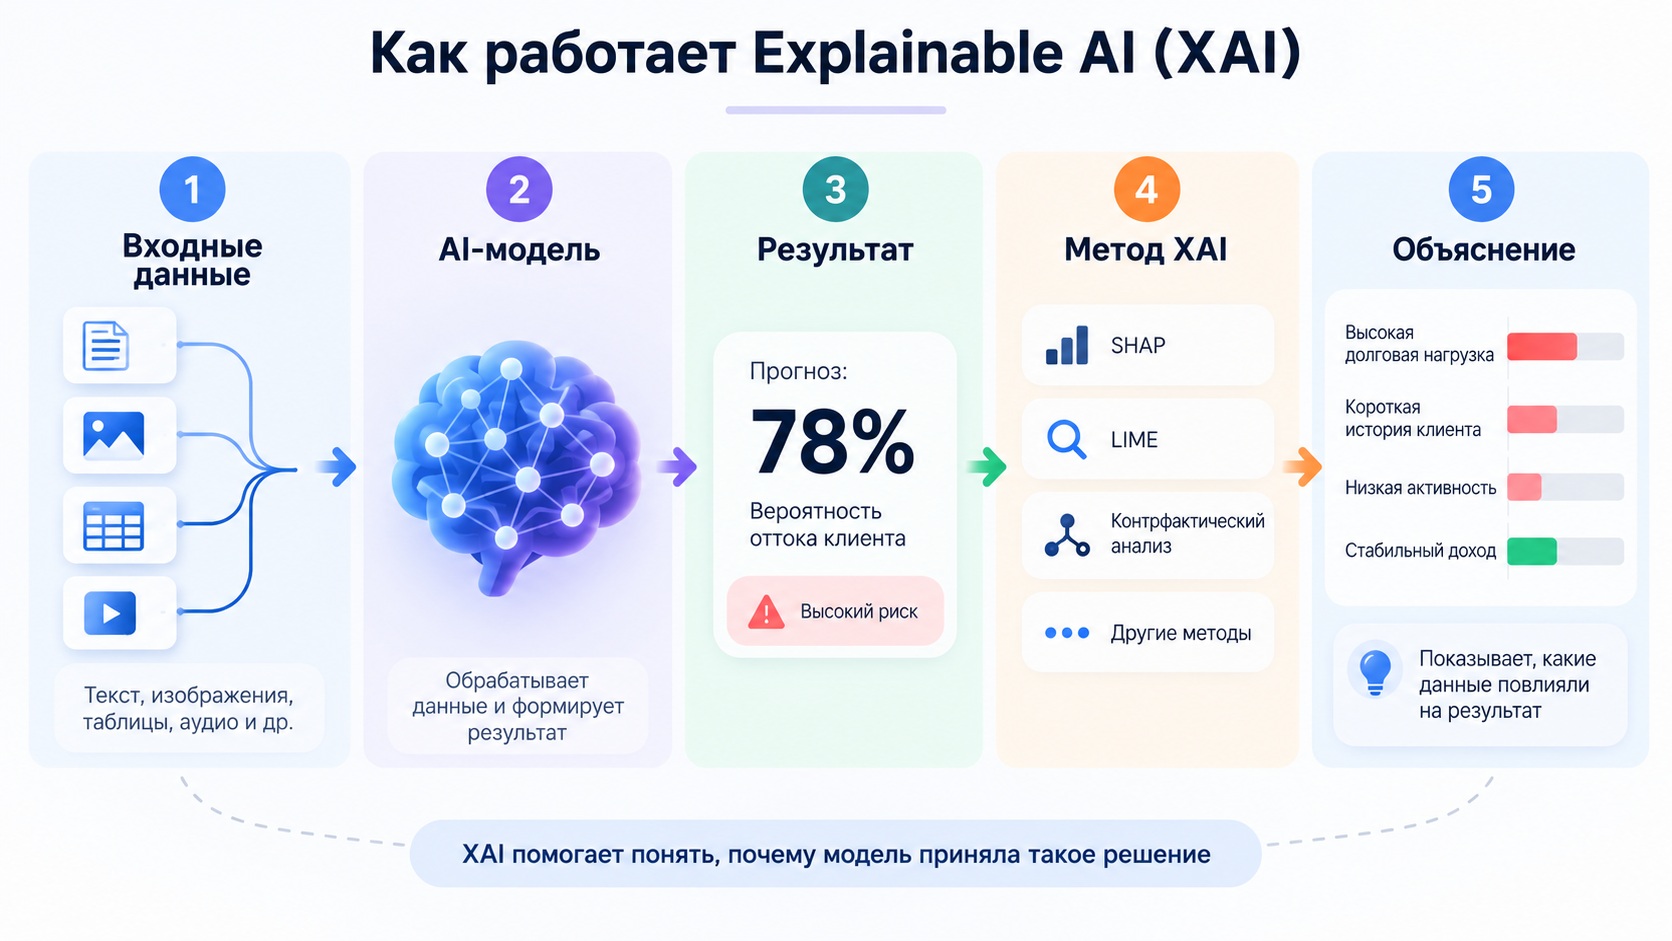
XAI — это группа методов, а не один универсальный алгоритм. Подход выбирают с учетом модели, типа данных и вопроса, на который требуется ответить.
Общая схема выглядит так:
Входные данные → AI-модель → результат → метод XAI → объяснение
Например, модель оценивает вероятность оттока клиента в 78%. Метод XAI дополнительно исследует, какие признаки связаны с этой оценкой и в какую сторону они изменяли прогноз.
Работа с XAI обычно проходит в несколько этапов:
1. Определить, что нужно объяснить. Это может быть один конкретный ответ модели или ее поведение в целом.
2. Выбрать способ анализа. Например, проверить, какие данные сильнее повлияли на результат, или посмотреть, как ответ изменится при других условиях.
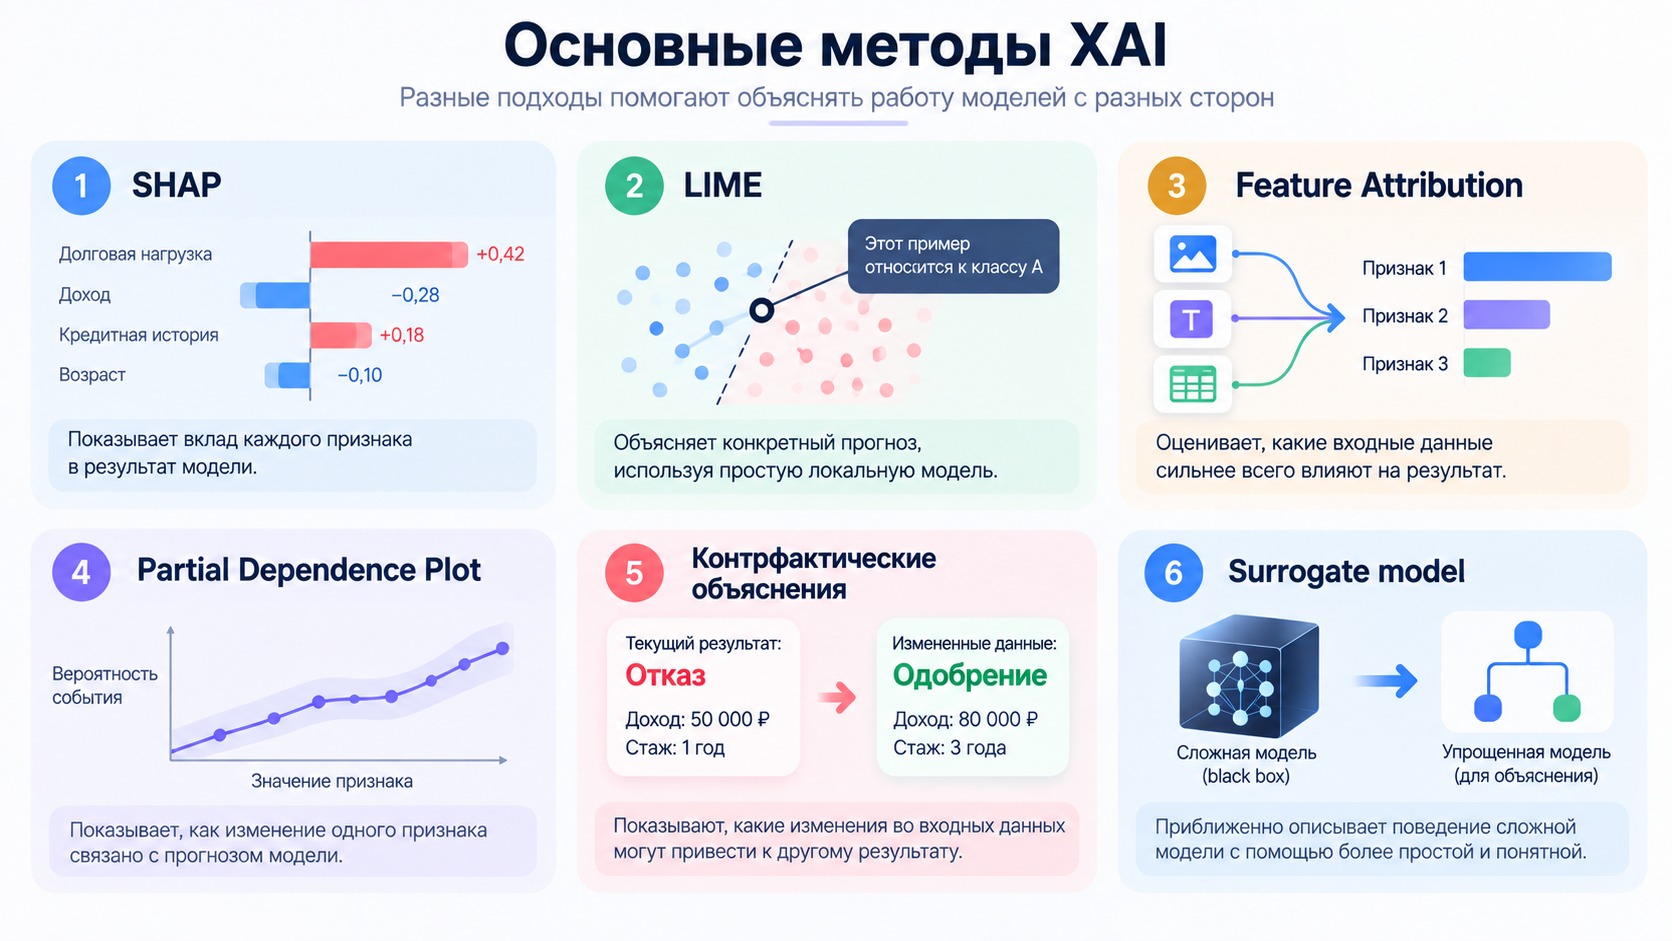
3. Применить подходящий метод XAI. Например, SHAP используют, чтобы оценить вклад отдельных признаков в результат, LIME — чтобы объяснить конкретный прогноз, а контрфактический анализ — чтобы понять, какие изменения входных данных могли бы привести к другому результату.
4. Проверить результат. Полезно изменить входные данные или способ анализа и посмотреть, останется ли объяснение похожим.
5. Показать вывод в понятной форме. Разработчику подойдет график с влиянием признаков, а бизнес-пользователю — краткий список факторов, которые сильнее всего повлияли на решение.
Локальные и глобальные объяснения
Один из базовых способов классификации XAI — разделение объяснений на локальные и глобальные.
|
Тип |
Что объясняет |
Пример |
|---|---|---|
|
Локальное объяснение |
Одно конкретное решение модели |
Почему модель присвоила конкретному клиенту высокий риск |
|
Глобальное объяснение |
Общие закономерности поведения модели |
Какие признаки чаще связаны с оценкой риска |
Локальный результат нельзя автоматически распространять на всю модель. Признак, который оказался значимым для одного объекта, может иметь другое значение для остальных данных.
Основные методы XAI
Для разных моделей используют разные способы интерпретации.
|
Метод |
Как работает |
Где применяют |
|---|---|---|
|
Интерпретируемые модели |
Логика модели изначально доступна человеку: например, коэффициенты линейной модели или ветви дерева решений |
Задачи, где прозрачность требуется уже на этапе проектирования |
|
Feature Attribution |
Оценивает вклад отдельных входных признаков в результат |
Табличные данные, тексты, изображения |
|
SHAP |
Рассчитывает вклад признаков в прогноз на основе идей значений Шепли |
Локальный и агрегированный анализ ML-моделей |
|
LIME |
Строит простую локальную модель около исследуемого примера |
Анализ отдельных прогнозов black-box-моделей |
|
Partial Dependence Plot |
Показывает связь изменения признака с прогнозом модели |
Исследование общего поведения модели |
|
Контрфактические объяснения |
Определяют, какие изменения входных условий связаны с другим результатом |
Сценарии вида «что должно измениться, чтобы прогноз стал другим» |
|
Surrogate model |
Приближенно описывает сложную модель с помощью более простой |
Исследование black-box-систем |
|
Методы интерпретации LLM |
Исследуют токены, представления, активации и внутренние компоненты модели |
Анализ больших языковых моделей |
SHAP
SHAP (SHapley Additive exPlanations) — метод, который показывает, какие признаки сильнее повлияли на конкретный результат модели.
Например, модель оценивает кредитную заявку как рискованную. SHAP помогает разложить этот результат по факторам:
- высокая долговая нагрузка повысила оценку риска;
- стабильный доход снизил ее;
- короткая кредитная история снова повысила.
В итоге специалист видит не только итоговый прогноз, но и вклад отдельных данных в него. Метод SHAP предложили Scott Lundberg и Su-In Lee в работе A Unified Approach to Interpreting Model Predictions.
SHAP используют и в готовых ML-сервисах. Например, Amazon SageMaker применяет этот метод для анализа того, как разные признаки влияют на прогноз модели.
LIME
LIME (Local Interpretable Model-Agnostic Explanations) — метод, который помогает объяснить один конкретный прогноз модели. Он работает так: немного изменяет исходные данные, несколько раз запрашивает у модели новый результат и смотрит, какие изменения сильнее всего на него повлияли. Затем LIME строит более простое объяснение поведения модели рядом с этим конкретным примером.
Например, если модель определила отзыв как негативный, LIME может показать, какие слова в тексте сильнее всего повлияли на такую классификацию. LIME хорошо подходит для объяснения отдельного решения, но по одному такому результату нельзя судить о поведении всей модели.
XAI и большие языковые модели
С большими языковыми моделями (LLM) объяснимость становится сложнее. Модель формирует последовательность токенов на основе большого числа параметров, поэтому текстовое пояснение ответа нельзя приравнивать к полной записи внутренних вычислений.
Для исследования LLM применяют:
- анализ влияния отдельных токенов;
- probing — исследование информации во внутренних представлениях;
- анализ активаций нейронов и слоев;
- методы на основе концептов;
- механистическую интерпретируемость;
- контролируемое изменение входных данных и сравнение результатов.
Как XAI связан с GEO
GEO (Generative Engine Optimization) связано с продвижением брендов и сайтов в генеративном поиске и ответах нейросетей. XAI здесь полезен как подход к анализу поведения AI-систем.
Специалист исследует, при каких условиях меняется AI-видимость бренда: какие формулировки запроса связаны с появлением компании в ответе, какие источники цитирует система, какие характеристики она относит к бренду и насколько результат повторяется при близких запросах.
XAI сам по себе не следует считать отдельным фактором GEO-ранжирования. Его практическая функция в GEO — помочь системно анализировать наблюдаемое поведение AI-поиска.
Что можно анализировать
1. Промпт. Как разные промпты и отдельные условия запроса связаны с составом ответа.
2. Упоминание бренда. Появляется ли компания в ответе и в каком контексте.
3. Источники. Какие сайты и страницы использует нейросеть.
4. Цитируемость. Какие материалы получают цитирование в AI-ответах и при каких запросах.
5. Устойчивость. Повторяется ли результат при близких формулировках.
6. Конкуренты. Какие компании появляются в тех же пользовательских сценариях.
7. Динамику. Как ответы меняются после обновления собственного контента или внешнего информационного поля.
При анализе источников имеет смысл учитывать их авторитет в AI-поиске: частота появления разных доменов помогает понять, какие площадки нейросети регулярно используют по конкретной тематике.
Пример применения XAI-подхода в GEO
Представим, что сервис аналитики проверяет присутствие бренда по запросу:
«Какие сервисы подходят для анализа видимости бренда в нейросетях?»
В одном варианте запроса бренд отсутствует, а после уточнения пользовательского сценария появляется в ответе.
Шаг 1. Зафиксировать исходные данные
Нужно сохранить:
- промпт;
- AI-систему;
- дату проверки;
- полный ответ;
- упомянутые бренды;
- доступные источники.
Шаг 2. Создать варианты промпта
Например:
- «сервисы анализа AI-видимости»;
- «российские сервисы анализа AI-видимости»;
- «сервисы для отслеживания упоминаний бренда в ChatGPT и Gemini»;
- «сервисы анализа источников, которые цитируют нейросети».
В каждом эксперименте лучше менять один параметр. Тогда проще определить, с каким условием совпало изменение результата.
Шаг 3. Сравнить ответы
|
Проверка |
Что анализировать |
|---|---|
|
Изменили формулировку задачи |
Появился ли бренд |
|
Добавили конкретный сценарий |
Изменился ли набор рекомендуемых компаний |
|
Запросили источники |
Какие домены появились в ответе |
|
Добавили характеристику продукта |
Какие бренды система связала с этим условием |
Шаг 4. Найти устойчивые закономерности
Если бренд регулярно появляется в ответах определенного типа, появляется основание для GEO-гипотезы: AI-система связывает компанию с конкретной темой, сценарием или набором характеристик.
Это пока гипотеза, а не доказанная причинная связь.
Шаг 5. Проверить источники
Следующий этап — выяснить, где содержится информация, которую воспроизводит система. Для этого анализируют собственный сайт, сайты конкурентов и регулярно цитируемые площадки. Рейтинг источников нейросетей Pixel Tools помогает сравнивать площадки, которые встречаются в AI-ответах.
Если один факт подтверждается несколькими независимыми площадками, полезно учитывать и Cross-source Verification — сопоставление информации по нескольким источникам.
Пример промпта для XAI-аудита GEO
«Проанализируй ответы нейросетей по этому набору промптов. Для каждого ответа выдели упомянутые бренды, характеристики брендов, использованные источники, подтверждаемые фактами утверждения и различия между вариантами запроса. Укажи, какие изменения ответа совпали с изменением конкретного условия промпта. Не реконструируй скрытые рассуждения модели. Разделяй наблюдения и гипотезы».
Такой запрос подходит для AI-аналитики уже собранных ответов: задача модели состоит в структурировании наблюдаемых данных, а не в попытке угадать собственные скрытые вычисления.
Как использовать XAI-подход при работе с GEO
Практический алгоритм:
- Собрать набор целевых пользовательских промптов.
- Получить ответы нескольких AI-систем.
- Зафиксировать бренд, конкурентов, источники и основные утверждения.
- Создать контролируемые варианты запросов.
- Менять один параметр за один эксперимент.
- Сравнивать изменения ответов.
- Проверять страницы, которые цитирует AI.
- Искать повторяющиеся связи между запросами, источниками и упоминаниями бренда.
- Формировать GEO-гипотезы.
- После изменений контента повторять тот же набор тестов.
Полученные гипотезы можно сопоставлять с рейтингом GEO-факторов Pixel Tools, где собраны факторы, связанные с присутствием брендов в ответах нейросетей.
Ошибки при работе с XAI
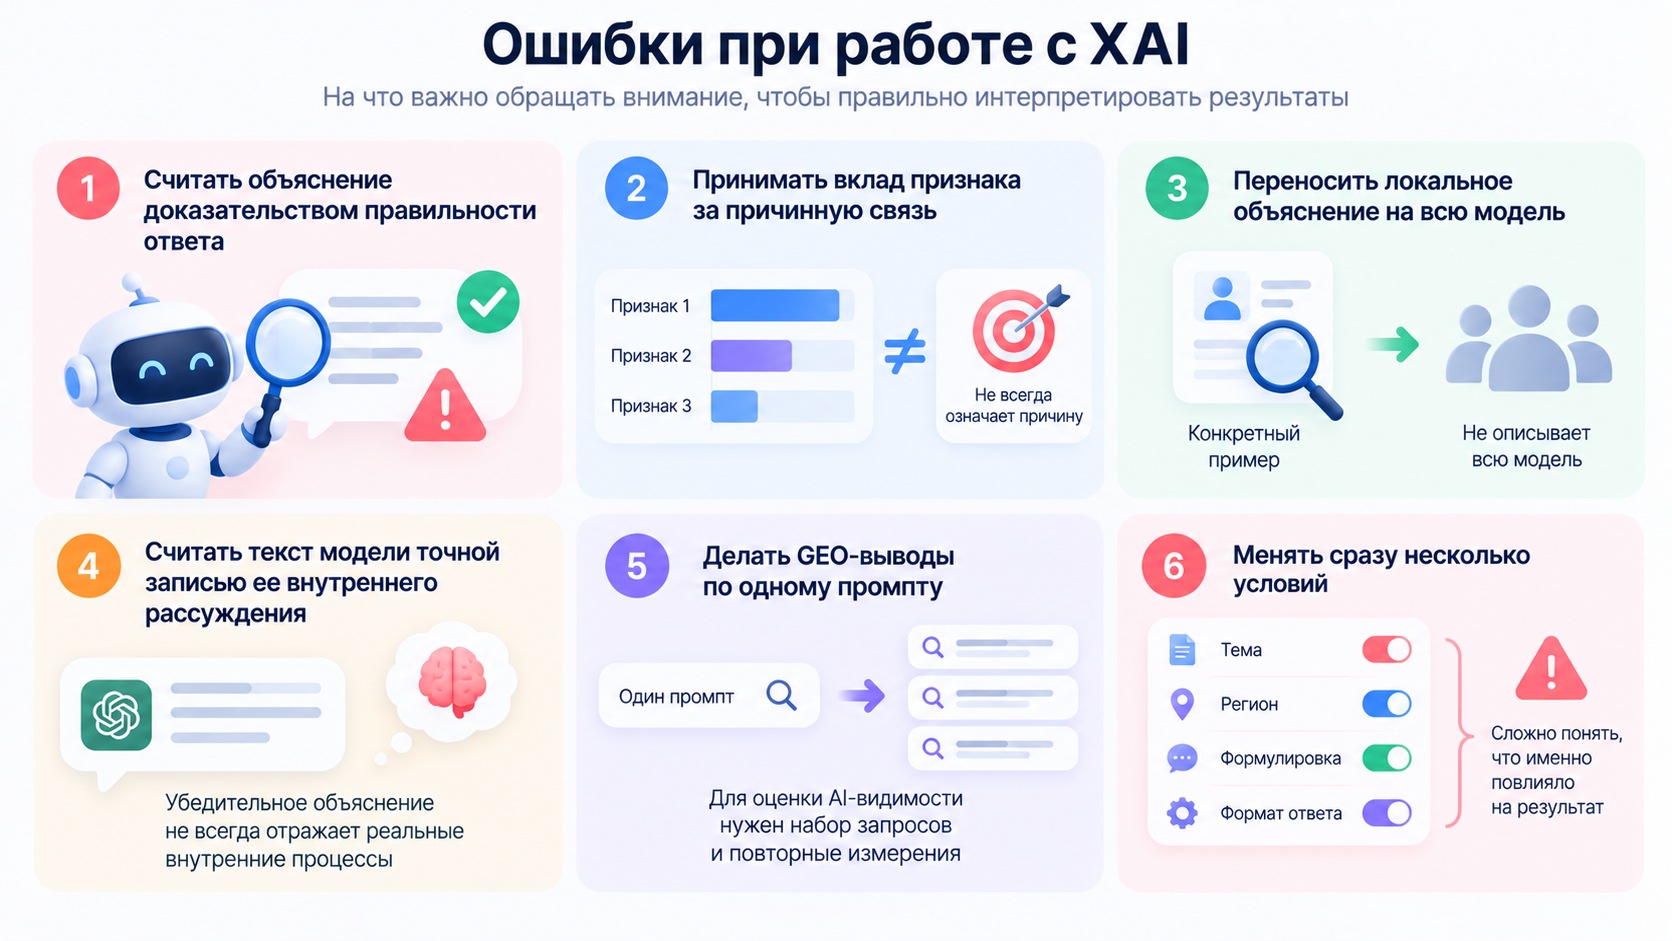
Считать объяснение доказательством правильности ответа
Понятное объяснение может сопровождать ошибочный прогноз. XAI помогает исследовать поведение модели, но не подтверждает фактическую корректность результата.
Принимать вклад признака за причинную связь
Высокое значение SHAP показывает вклад признака в прогноз конкретной модели. Оно не доказывает, что этот признак является причиной события в реальном мире.
Переносить локальное объяснение на всю модель
Причины конкретного результата не описывают автоматически поведение модели на всех данных.
Считать текст модели точной записью ее внутреннего рассуждения
Модель способна сформировать убедительное объяснение собственного ответа, однако соответствие такого текста реальным внутренним процессам требует отдельной проверки.
Делать GEO-выводы по одному промпту
Единичный ответ показывает конкретное наблюдение. Для оценки AI-видимости нужен набор релевантных пользовательских запросов и повторные измерения.
Менять сразу несколько условий
Если одновременно изменить тему, регион, формулировку и формат результата, установить связь между конкретным изменением и ответом станет значительно сложнее.
Чек-лист XAI-аудита AI-ответов
Перед выводами проверьте:
- сохранен исходный промпт;
- указаны AI-система и дата проверки;
- зафиксирован полный ответ;
- сохранены доступные источники;
- отмечены упомянутые бренды;
- наблюдаемые данные отделены от гипотез аналитика;
- варианты промпта отличаются контролируемым параметром;
- локальный результат не выдается за общее правило;
- текстовое объяснение модели не считается записью ее внутренних вычислений;
- эксперимент можно повторить при следующем измерении.
Самые популярные термины