Эмбеддинг
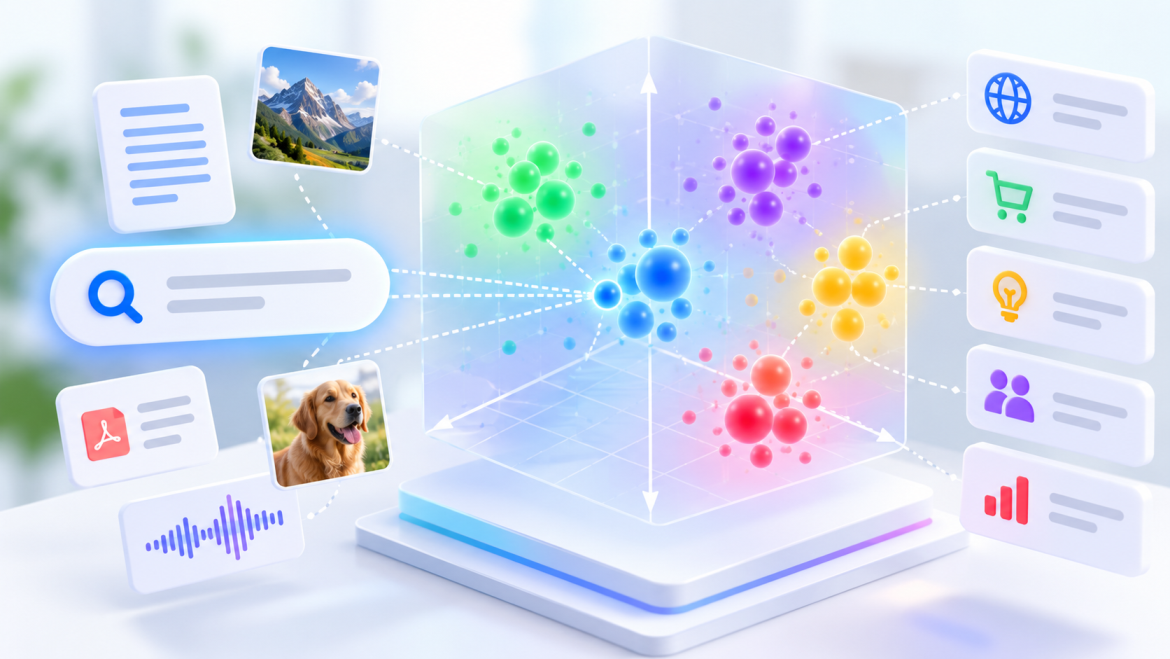
Эмбеддинг (от англ. embedding) — числовое векторное представление текста, изображения, аудио или другого объекта. Модель преобразует объект в последовательность чисел так, чтобы математические операции над векторами помогали находить смысловые и другие значимые связи между объектами.
Эмбеддинги применяют в семантическом поиске, RAG-системах, рекомендациях, кластеризации, классификации и поиске аномалий. OpenAI, например, относит search, clustering, recommendations, anomaly detection и classification к основным задачам своих embedding-моделей.
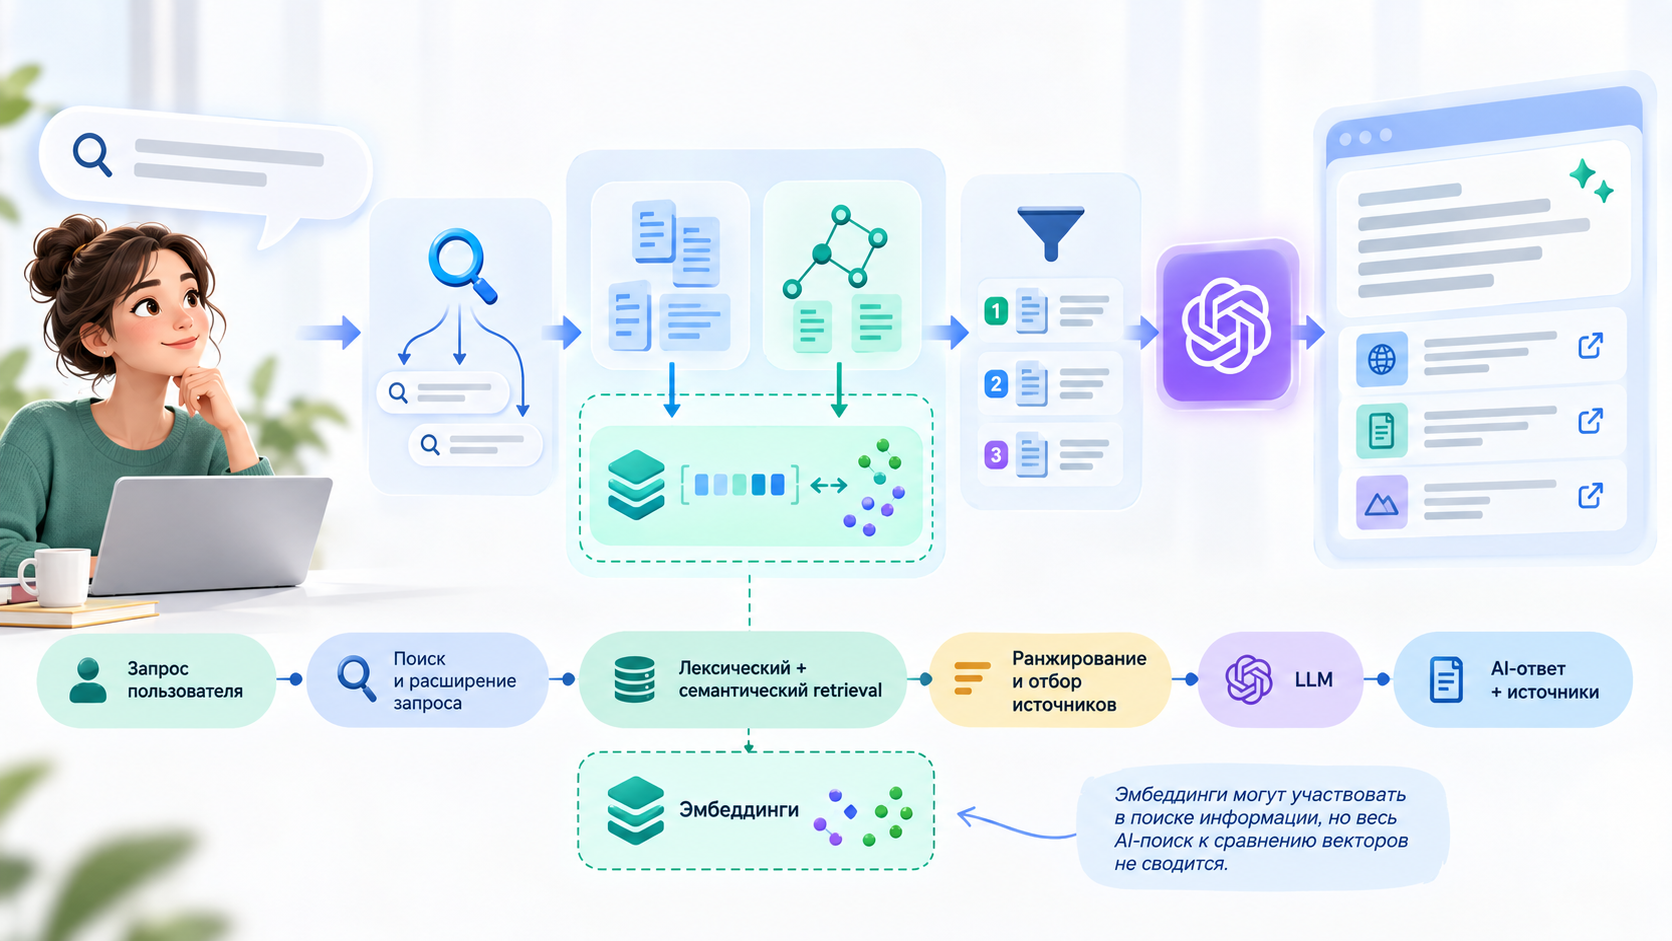
В AI-поиске роль эмбеддингов зависит от архитектуры конкретной системы. Они могут использоваться для семантического поиска и извлечения информации, однако публичные сервисы вроде ChatGPT Search, Google AI Mode, Алисы AI и Perplexity задействуют более сложные механизмы поиска, отбора источников и формирования ответа. Поэтому в GEO эмбеддинги стоит рассматривать как один из механизмов, который помогает системе находить контент, близкий по смыслу к запросу. При этом выбор источника зависит и от других факторов поиска и ранжирования.
Что такое эмбеддинг простыми словами
Компьютерная модель преобразует текст, изображение или другой объект в набор чисел — вектор. Благодаря этому она может сравнивать объекты по смыслу, например, находить похожие тексты или подбирать изображение по описанию.
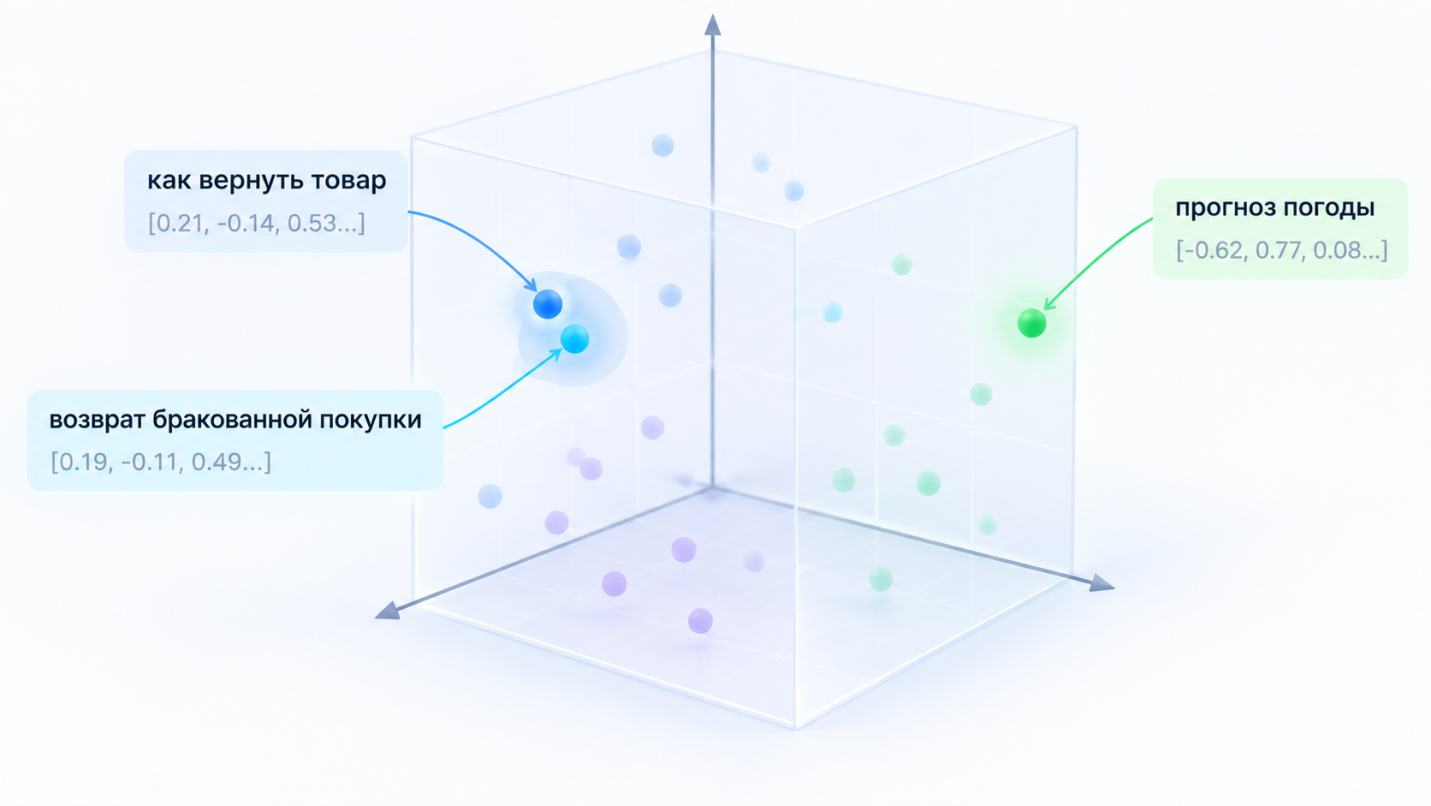
Вектор можно представить как массив чисел фиксированной длины:[0.021, -0.147, 0.534, ...]
Отдельные координаты такого вектора обычно нельзя однозначно интерпретировать как конкретные человеческие понятия. Значение имеет положение объекта в пространстве в целом.
Если embedding-модель обучена для семантического сопоставления текстов, похожие по смыслу фрагменты обычно располагаются ближе друг к другу. Поэтому запрос «как вернуть бракованный товар» может оказаться близким к тексту «порядок возврата некачественной продукции», хотя формулировки почти не совпадают.
Размер вектора зависит от модели. Современные системы поддерживают разные размерности. Например, Google Gemini Embedding 2 работает с размерностями от 128 до 3072 и рекомендует варианты 768, 1536 и 3072. text-embedding-3-large от OpenAI формирует векторы размерностью до 3072 и поддерживает сокращение результата через параметр dimensions.
Чем семантический поиск отличается от поиска по словам
Поиск по словам ориентируется на сами формулировки запроса: какие слова использованы, в какой форме и как часто они встречаются в документе. Семантический поиск оценивает смысл запроса и сравнивает его с содержанием документов с помощью векторных представлений.
Благодаря этому система может находить релевантные материалы даже тогда, когда в запросе и тексте используются разные слова. Например, запрос «как закрыть ИП» может привести к документу «порядок прекращения деятельности индивидуального предпринимателя».
На практике эти подходы часто работают вместе. Поисковая система может учитывать совпадения по словам, смысловую близость, структуру документа и другие сигналы. Такое сочетание помогает точнее подбирать результаты под запрос пользователя.
Как появились современные эмбеддинги
Идея распределенных числовых представлений появилась задолго до генеративных моделей. Один из заметных этапов развития технологии связан с word2vec, который Томаш Миколов и его коллеги из Google представили в 2013 году. В работе описаны две архитектуры для построения векторных представлений слов — Continuous Bag-of-Words (CBOW) и Skip-gram.
Word2vec показал, что в векторном пространстве могут проявляться семантические и синтаксические закономерности. Классическая иллюстрация выглядит так:
vector("king") − vector("man") + vector("woman") ≈ vector("queen")
Этот пример описан в работе Миколова, Скотта Вэнь-тау Ии Джеффри Цвейга о лингвистических закономерностях в непрерывных векторных пространствах. Авторы показали, что некоторые отношения между словами проявляются как сходные векторные смещения.
У word2vec и похожих статических моделей есть ограничение: одно слово получает одно базовое представление независимо от конкретного предложения. Контекстные модели изменили этот подход.
В 2018 году появился BERT, который строит двунаправленные контекстные представления: значение токена рассчитывается с учетом контекста слева и справа.
Для задач семантического поиска следующим заметным этапом стал Sentence-BERT, опубликованный в 2019 году. Архитектура была разработана специально для получения семантически содержательных представлений предложений, которые можно сравнивать, например, с помощью косинусного сходства.
Сегодня для работы с эмбеддингами используют специальные модели, например OpenAI text-embedding-3, Cohere Embed, Gemini Embedding, E5 и BGE. Они преобразуют текст и другие данные в векторы, которые затем применяют для семантического поиска, группировки материалов и классификации.
Как строят эмбеддинги для векторного поиска
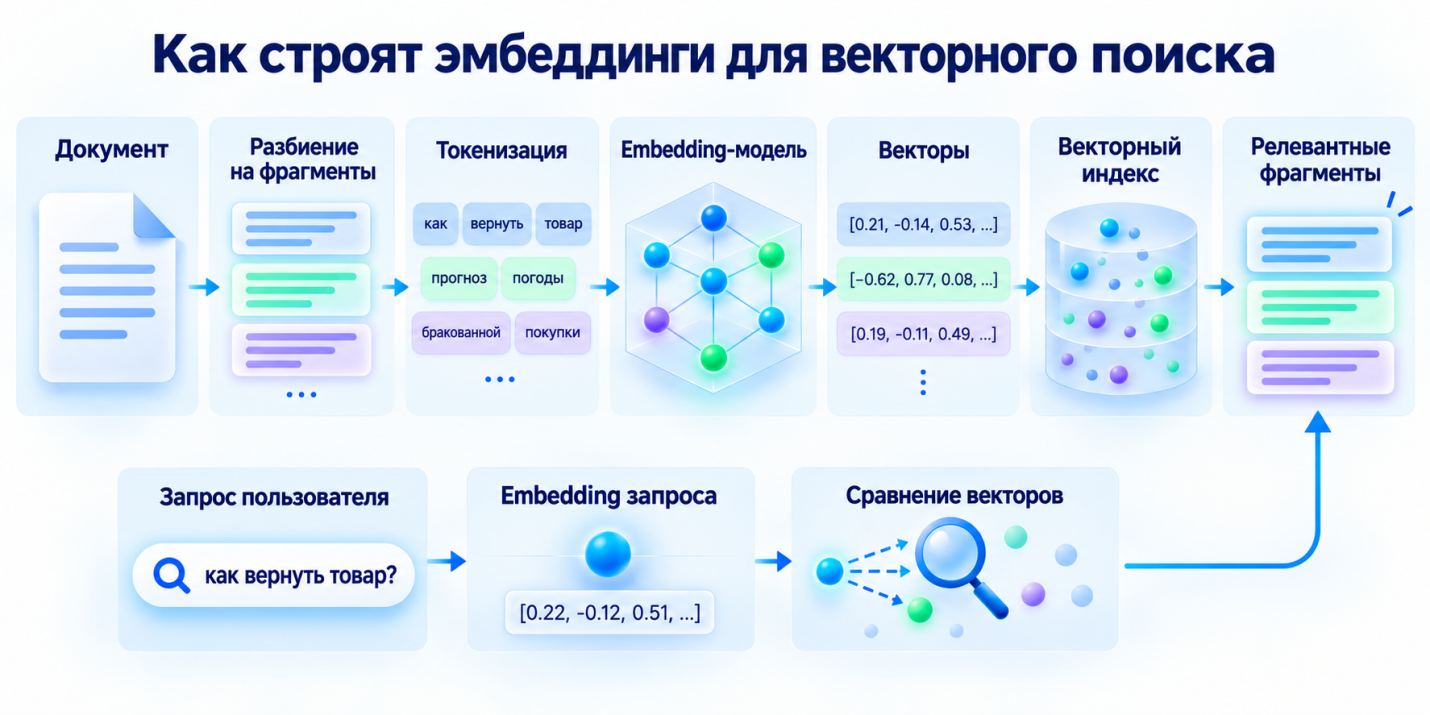
Конкретный пайплайн зависит от модели и инфраструктуры. Для поиска по большой коллекции документов часто используют несколько этапов.
1. Подготовка и разбиение документов
Длинные документы обычно делят на фрагменты, чтобы поиск возвращал конкретный релевантный участок текста. Границы можно определять по абзацам, разделам, количеству токенов или другим правилам.
Единого размера чанка для всех задач нет. Его подбирают под тип документов и используемую модель. Слишком большой фрагмент может содержать сразу несколько тем, а слишком маленький — потерять часть контекста.
2. Токенизация
Текст преобразуется в токены, с которыми работает модель. Токен может соответствовать слову, части слова, знаку или другой единице, которую определяет токенизатор.
3. Вычисление векторного представления
Embedding-модель обрабатывает входные данные и возвращает вектор фиксированной размерности. Внутренняя схема получения итогового представления зависит от архитектуры конкретной модели.
4. Нормализация
Некоторые модели дополнительно нормализуют полученные векторы, чтобы их было удобнее сравнивать. Например, OpenAI возвращает векторы, нормализованные до длины 1. Для них косинусное сходство и евклидово расстояние дают одинаковый порядок результатов. При этом нормализация нужна не во всех моделях. Поэтому при работе с эмбеддингами стоит учитывать рекомендации разработчика конкретной модели.
5. Индексация и поиск ближайших объектов
Полученные векторы сохраняют в специальном индексе. Когда пользователь вводит запрос, система тоже преобразует его в вектор и сравнивает с уже сохраненными. Так она находит тексты, изображения или другие объекты, которые ближе всего по смыслу.
Если данных очень много, для ускорения поиска применяют специальные алгоритмы. Например, pgvector поддерживает HNSW и IVFFlat, а также несколько способов сравнения векторов, включая косинусное и евклидово расстояние.
Как сравнивают эмбеддинги
Одна из распространенных метрик — косинусное сходство. Оно оценивает направление двух векторов: чем ближе направления, тем выше значение сходства.
Однако метрику выбирают с учетом того, как обучалась конкретная модель. Наряду с cosine similarity применяются dot product, Euclidean distance и другие варианты.
По этой причине при подключении новой embedding-модели необходимо проверить:
- какую метрику рекомендует разработчик;
- нормализуется ли результат;
- какую размерность возвращает модель;
- совместимы ли параметры модели с выбранным векторным индексом.
Само числовое значение сходства нельзя трактовать как универсальную вероятность того, что два текста имеют одинаковый смысл. Порог релевантности обычно калибруют на данных конкретного проекта.
Виды эмбеддингов
|
Тип |
Что кодирует |
Где применяется |
|---|---|---|
|
Word embeddings |
Отдельные слова |
Исторические и специализированные NLP-задачи |
|
Sentence embeddings |
Предложения и небольшие текстовые фрагменты |
Семантический поиск, кластеризация, классификация |
|
Document embeddings |
Более крупные тексты |
Поиск, рекомендации, группировка документов |
|
Text-image embeddings |
Текст и изображения в согласованном пространстве |
Поиск изображения по описанию, визуальный поиск |
|
Мультимодальные эмбеддинги |
Несколько типов данных в общем пространстве |
Поиск по тексту, изображениям, аудио, видео и документам |
|
Embeddings пользователей и объектов |
Характеристики взаимодействий, товаров, контента или пользователей |
Рекомендательные системы |
CLIP — пример модели, которая обучает текстовый и визуальный энкодеры на связанных парах «изображение — текст». Это делает ее примером совместного text-image representation learning, а не исключительно image embedding. Работа CLIP опубликована в 2021 году.
Современные системы расширяют этот подход. Gemini Embedding 2, например, объединяет в одном пространстве текст, изображения, видео, аудио и PDF.
Эмбеддинг и смежные понятия
|
Понятие |
Что делает |
Отличие от эмбеддинга |
|---|---|---|
|
Токен |
Единица, на которую токенизатор разбивает входные данные |
Embedding представляет токен или более крупный объект числовым вектором |
|
Генерирует и обрабатывает последовательности данных |
Embedding — представление объекта, LLM — модель с гораздо более широким набором функций |
|
|
Векторная база |
Хранит, индексирует и ищет векторы |
База работает с embeddings, а некоторые платформы дополнительно умеют создавать их |
|
RAG |
Подключает внешние источники знаний к генерации ответа |
Vector retrieval может быть одним из способов извлечения данных внутри RAG |
|
Косинусное сходство |
Сравнивает направление двух векторов |
Это метрика сравнения, а не представление данных |
|
Ищет информацию и формирует ответ в генеративной форме |
В его архитектуре могут сочетаться поиск, ранжирование, retrieval и генерация |
Где применяются эмбеддинги
Семантический поиск
Эмбеддинги помогают находить материалы по смыслу, даже если в запросе и документе используются разные слова. Такой подход применяют в базах знаний, каталогах и поиске по внутренним документам.
RAG-системы
В RAG-системах поиск находит подходящие фрагменты из внешних источников и передает их языковой модели для подготовки ответа. Для поиска могут использоваться векторные, лексические и гибридные методы.
Рекомендательные системы
Эмбеддинги помогают находить похожие товары, статьи, музыку и другой контент. Система сравнивает векторные представления объектов и подбирает близкие по характеристикам варианты.
Кластеризация и классификация
С помощью эмбеддингов можно группировать похожие тексты и распределять их по категориям. Например, автоматически объединять отзывы или обращения пользователей по темам.
Поиск аномалий
Эмбеддинги также используют для поиска объектов, которые заметно отличаются от основной группы. Это может применяться как дополнительный сигнал при анализе подозрительных транзакций, спама или необычного поведения.
Какую роль эмбеддинги играют в AI-поиске
Векторный поиск часто используют в RAG-системах и поиске по собственным базам данных. Запрос пользователя преобразуется в эмбеддинг, после чего система находит близкие по смыслу документы или отдельные фрагменты.
Публичные AI-поисковики работают сложнее. Они могут использовать несколько этапов поиска и ранжирования. ChatGPT Search может преобразовать запрос пользователя в несколько уточненных поисковых запросов и при необходимости выполнить дополнительные поиски. Google AI Mode использует подход query fan-out: система разбивает исходный вопрос на подтемы и выполняет несколько поисков параллельно.
Поиск с Алисой анализирует найденные в Поиске материалы, выбирает подходящие фрагменты и формирует ответ со ссылками. Perplexity также ищет информацию в интернете, отбирает источники и на их основе создает ответ с цитатами.
Поэтому сравнение эмбеддингов — один из способов найти релевантный контент, но выбор источников в AI-поиске зависит и от других механизмов поиска и ранжирования.
Эмбеддинги и GEO
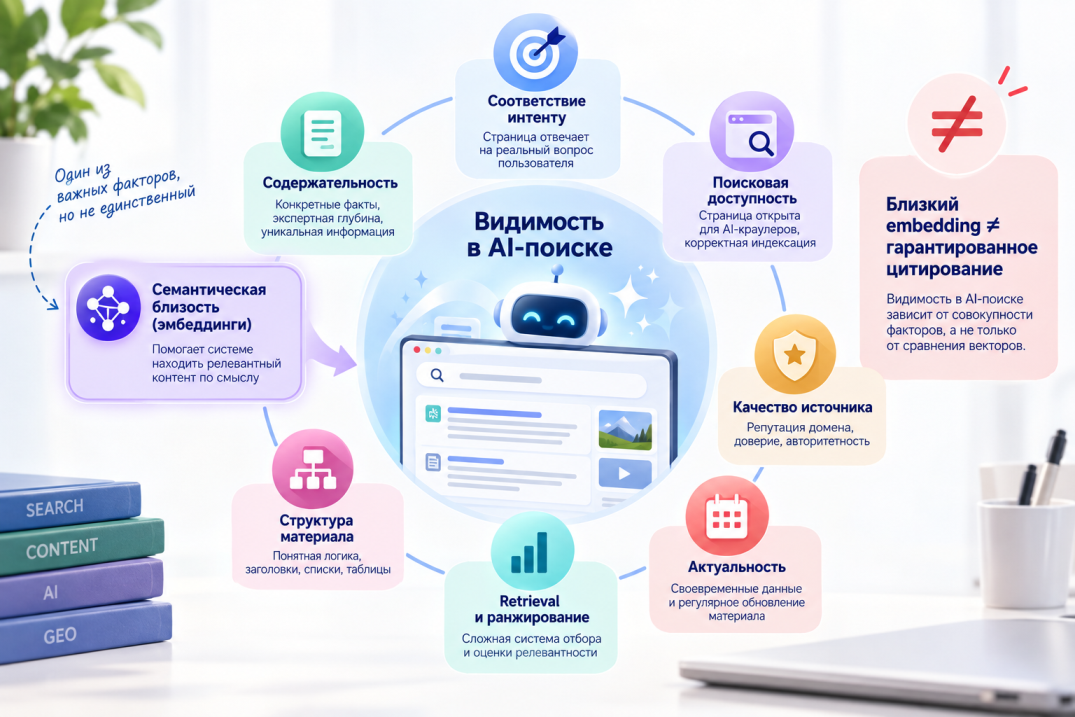
GEO работает с видимостью сайта и бренда в генеративных ответах. Знание embeddings полезно здесь, прежде всего, для понимания семантической релевантности. Системе проще извлекать материал, который содержательно отвечает на конкретную информационную потребность пользователя.
Однако видимость в AI-поиске нельзя рассчитывать по принципу «чем ближе embedding страницы к запросу, тем выше шанс цитирования». Публичные поисковые сервисы используют собственные механизмы retrieval, ранжирования, оценки качества и генерации.
Google рекомендует использовать для AI-поиска те же базовые принципы, что и для обычного поиска: страница должна быть доступна для индексации, содержать полезную информацию и отвечать на запрос пользователя.
Яндекс также указывает, что Алиса чаще использует информативные, хорошо структурированные и релевантные материалы. При оценке видимости учитываются страницы, которые уже хорошо представлены в поиске, а среди характеристик контента Яндекс выделяет полезность, содержательность, оригинальность и экспертность.
Поэтому в GEO стоит работать над качеством и полнотой материалов, их доступностью для поиска и точным соответствием пользовательским запросам. Для оценки таких параметров можно использовать рейтинг GEO-факторов.
Как готовить контент с учетом семантического поиска и GEO
Давать прямой ответ на интент раздела
Если раздел отвечает на вопрос «Сколько времени внедряется CRM?», первые предложения должны раскрывать именно срок, условия и основные этапы внедрения. Общие фразы о пользе автоматизации затрудняют извлечение конкретного ответа и мало помогают читателю.
Раскрывать тему через связанные сущности и вопросы
Один термин редко исчерпывает пользовательский интент. Материал о CRM для логистики может включать интеграцию с TMS, API, расчет тарифов, работу с заявками, маршрутами и документами, если эти вопросы действительно относятся к продукту.
Полнота должна формироваться содержанием, а не повторением ключевых фраз.
Использовать понятную структуру
Заголовки помогают разделять разные вопросы и упрощают навигацию. В собственной RAG-системе структура документа также может использоваться при настройке чанкинга.
Для публичного AI-поиска нельзя считать каждый H2 гарантированной границей отдельного embedding. Формат страницы стоит выбирать, прежде всего, по логике темы и удобству извлечения конкретной информации.
Убирать бессодержательные дубли
Несколько страниц с почти одинаковым содержанием редко расширяют тематическое покрытие. Полезнее разделять материалы по реальным интентам и давать каждому документу собственную задачу.
Поддерживать актуальность
После существенного изменения документа embeddings в собственной базе знаний необходимо пересчитать или переиндексировать затронутые фрагменты. Иначе retrieval продолжит работать с прежним представлением текста. Для сайта одновременно требуется следить за переобходом и актуальностью индексируемых страниц.
Использовать FAQ по реальным вопросам аудитории
FAQ удобен, когда пользователю требуются короткие ответы на самостоятельные вопросы. Каждый ответ должен содержать информацию, которой нет в основном тексте, либо давать более компактную форму уже раскрытого материала.
Подробнее о построении таких разделов — в материале «FAQ и knowledge-гайды».
Описывать продукт конкретно
Вместо общих характеристик полезнее указывать назначение продукта, функции, ограничения, сценарии использования, условия подключения и критерии сравнения. Эти сведения помогают поисковой системе и читателю соотнести страницу с конкретным запросом.
Как проверить семантическую близость контента к запросу
Если требуется проверить именно embeddings, анализ проводят математически:
- Выбирают одну embedding-модель.
- Получают embedding пользовательского запроса.
- Этой же моделью получают embeddings проверяемых фрагментов.
- Сравнивают векторы рекомендованной для модели метрикой.
- Смотрят, какие фрагменты получают более высокую релевантность на наборе реальных запросов.
- Проверяют результаты вручную и настраивают retrieval по тестовой выборке.
Для моделей OpenAI можно использовать косинусное сходство. Их векторы нормализованы, поэтому косинусное и евклидово расстояние дают одинаковый порядок результатов.
Такой способ подходит для собственной RAG-системы или проверки семантической близости контента в выбранной модели. Он не показывает, как именно ранжируют источники ChatGPT Search, Google AI Mode, Алиса AI или Perplexity.
Видимость в этих сервисах проверяют отдельно: составляют список целевых запросов, запускают их в каждой системе и фиксируют, упоминается ли бренд и какие источники попадают в ответ.
Итог: эмбеддинг в трех тезисах
- Эмбеддинг переводит объект в числовое векторное представление. Такое представление можно использовать для поиска сходства, кластеризации, классификации, рекомендаций и других задач.
- Векторный retrieval широко применяется в RAG и семантическом поиске. При этом RAG может использовать лексические, векторные и гибридные методы поиска, а публичные AI-поисковики задействуют собственные многоэтапные системы retrieval и ранжирования.
- Для GEO embeddings помогают понять принцип семантической релевантности, но не дают формулу попадания в AI-ответ. Практическая работа с AI-видимостью строится вокруг релевантного и содержательного контента, поисковой доступности страниц, полного раскрытия интента и фактической проверки упоминаний в генеративных системах.
Самые популярные термины