Deep Research
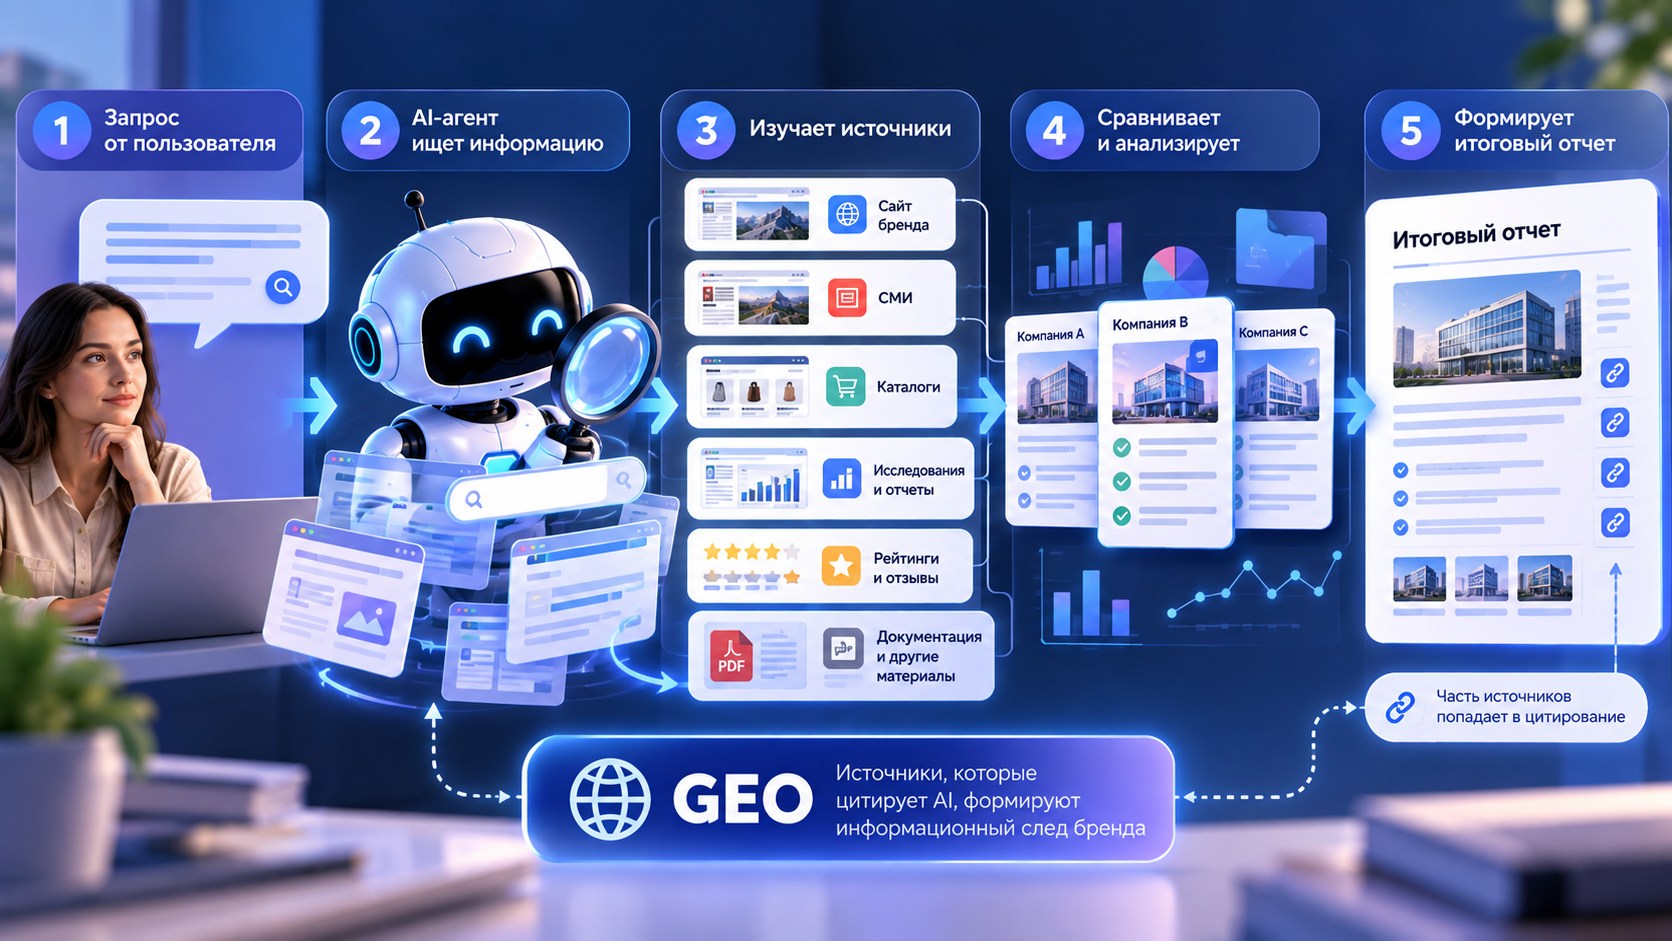
Deep Research (глубокое исследование) — режим многошагового AI-исследования, в котором система планирует поиск, последовательно обращается к источникам, анализирует найденные данные и формирует итоговый отчет со ссылками. В зависимости от сервиса и задачи агент может обработать десятки или сотни источников, а исследование занимает минуты вместо нескольких секунд.
Для GEO такой режим интересен тем, что в итоговом отчете видны использованные и процитированные источники, а некоторые сервисы дополнительно показывают ход исследования. По ним можно оценивать, какие материалы система находит, на какие площадки опирается и появляется ли среди них информация о бренде.
Что такое Deep Research простыми словами
Обычный чат стремится быстро сформировать ответ и при необходимости обращается к поиску. Deep Research рассчитан на более длительную исследовательскую работу.
Например, есть задача: «Изучить рынок, сравнить компании по пяти критериям, проверить цены по первоисточникам и подготовить отчет со ссылками». В режиме Deep Research система может сначала составить план, затем выполнить серию поисков, изучить найденные страницы и документы, скорректировать направление исследования и собрать результаты в один отчет.
OpenAI определяет Deep Research в ChatGPT как агентную функцию для многоэтапного исследования в интернете. Система может находить, анализировать и синтезировать сотни онлайн-источников.
Perplexity описывает сходный процесс: Deep Research итеративно выполняет поиск, читает документы, анализирует полученную информацию и корректирует дальнейшие шаги по мере исследования темы.
Чем Deep Research отличается от обычного AI-поиска
|
Параметр |
Обычный чат |
AI-поиск |
Deep Research |
|---|---|---|---|
|
Скорость |
Обычно секунды |
Обычно секунды или минуты |
Минуты, в сложных задачах дольше |
|
Работа с источниками |
Может выполняться без веб-поиска |
Поиск информации для формирования ответа |
Итеративное исследование с повторными поисками |
|
Планирование |
Обычно минимальное |
Зависит от продукта |
Может использовать отдельный план исследования |
|
Результат |
Ответ на запрос |
Ответ со ссылками на найденные материалы |
Развернутый отчет с источниками |
|
Ход работы |
Обычно скрыт от пользователя |
Частично зависит от сервиса |
В ряде продуктов можно видеть план или этапы исследования |
|
Типичные задачи |
Объяснения, тексты, идеи |
Актуальные факты, поиск информации |
Сравнения, обзоры рынка, анализ большого числа источников, due diligence |
Deep Research используют и как название конкретных функций в AI-сервисах, и как общее обозначение многошаговых исследовательских агентов. Например, у ChatGPT, Gemini и Perplexity есть продукты с названием Deep Research, а аналогичная функция Claude называется Research.
Как работает Deep Research
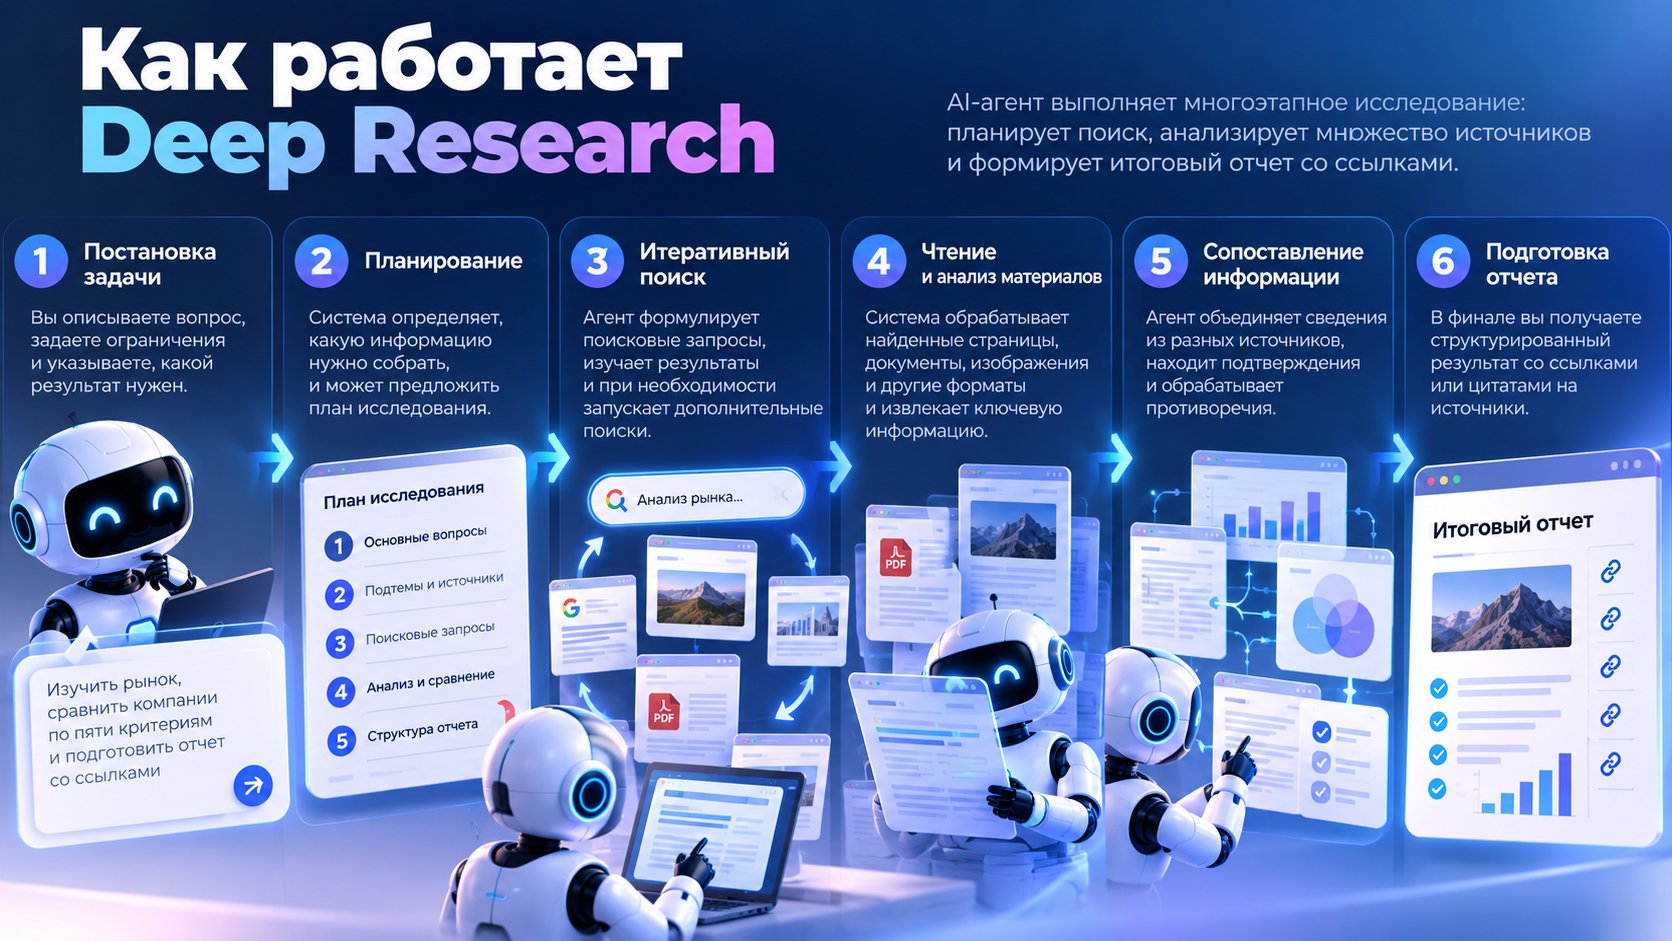
У разных продуктов нет единой архитектуры. Если обобщить официальные описания OpenAI, Google и Anthropic, процесс выглядит примерно так.
1. Постановка задачи
Пользователь описывает вопрос, ограничения и ожидаемый формат результата. Сервис может задать уточняющие вопросы или предложить план исследования.
Gemini, например, создает план до начала исследования и разрешает пользователю его отредактировать.
2. Планирование
Система определяет, какую информацию нужно собрать и какие подтемы исследовать. Архитектура зависит от продукта. В системе Anthropic главный агент изучает запрос, делит задачу на несколько направлений и поручает каждое из них отдельному субагенту.
3. Итеративный поиск
Агент формулирует поисковые запросы, изучает результаты, замечает пробелы и запускает дополнительные поиски. Поэтому траектория исследования заранее не фиксирована полностью: новая информация способна изменить следующие запросы.
4. Чтение и анализ материалов
Система обрабатывает найденные страницы и другие доступные ей форматы. Например, OpenAI указывает, что Deep Research работает с текстом, изображениями и PDF, а пользователь может передавать файлы и таблицы вместе с запросом.
5. Сопоставление информации
Агент объединяет сведения из разных источников, ищет подтверждения и обрабатывает противоречия.
Сам факт использования нескольких страниц еще не гарантирует корректную проверку. Качество результата зависит от найденных источников, архитектуры системы и того, насколько верно модель интерпретировала информацию.
6. Подготовка отчета
В финале пользователь получает структурированный результат со ссылками или цитатами.
Почему Deep Research требует больше ресурсов
Многошаговый агент несколько раз обращается к модели, поиску и другим инструментам, поэтому такой процесс требует больше вычислений, чем обычный ответ.
В экспериментах Anthropic агенты использовали примерно в четыре раза больше токенов, чем обычный чат, а мультиагентные системы — примерно в 15 раз больше. Эти данные относятся к архитектуре Anthropic и не показывают расход ресурсов всех сервисов Deep Research.
Где применяется Deep Research
Исследовательские агенты подходят для задач, которые требуют работы с большим количеством источников:
- анализ рынка и конкурентов;
- сравнение продуктов, сервисов и технологий;
- поиск и первичный отбор поставщиков или подрядчиков;
- обзор научных публикаций;
- анализ отраслевых тенденций;
- подготовка материалов к переговорам и закупкам;
- исследование внутренних корпоративных данных при наличии соответствующих подключений.
Как использовать Deep Research на практике
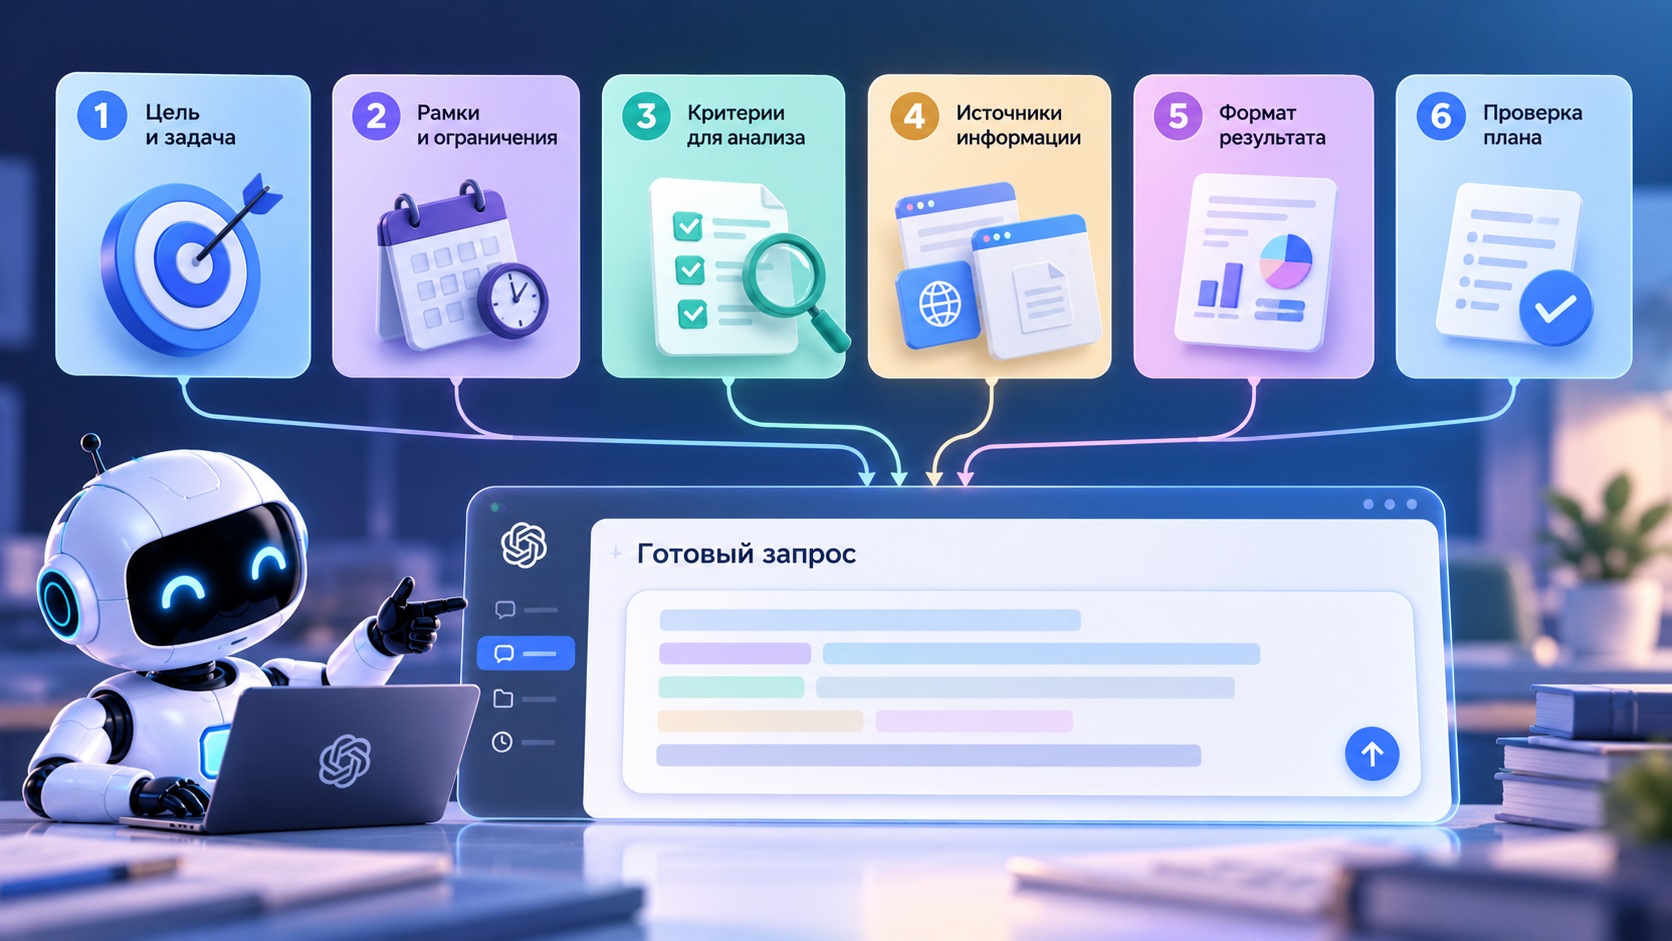
Качество исследования во многом задается исходным запросом. Чем яснее цель и критерии, тем проще агенту построить полезный план.
Алгоритм подготовки запроса:
- Определите цель. Укажите, какой вопрос должен закрыть отчет.
- Задайте рамки. Например, период, регион, отрасль, бюджет или тип компаний.
- Перечислите критерии. Они нужны, если требуется сравнить несколько вариантов.
- Укажите предпочтительные источники. Для фактов и цифр можно запросить официальные сайты, документацию, государственные базы и первичные исследования.
- Задайте формат результата. Например, сравнительная таблица, выводы по каждому критерию и перечень неподтвержденных данных.
- Проверьте план, если сервис показывает его до запуска.
- После получения отчета откройте источники, на которых основаны наиболее значимые цифры и выводы.
Пример промпта
Изучи рынок российских платформ для GEO-аналитики за последние 12 месяцев. Сравни не менее пяти сервисов по охвату нейросетей, глубине аналитики, наличию API и стоимости. Используй в первую очередь официальные сайты, документацию и первичные источники. Для существенных фактов укажи источник. В конце составь сравнительную таблицу и отдельно перечисли сведения, которые не удалось подтвердить.
Требование отмечать неподтвержденные данные помогает задать модели формат проверки, но не гарантирует отсутствие ошибок.
Deep Research может допускать фактические ошибки и неверные выводы, с трудом отличать достоверную информацию от слухов и недостаточно точно оценивать собственную уверенность. Поэтому существенные цифры и выводы стоит проверять по первоисточникам.
Deep Research и GEO
Для GEO исследовательские агенты интересны в тех сценариях, где пользователь просит AI сравнить бренды, найти поставщиков, выбрать сервисы или составить обзор рынка.
Например:
- «Какие CRM подходят небольшому интернет-магазину?»;
- «Сравни агентства, которые занимаются GEO-продвижением»;
- «Какие российские платформы помогают отслеживать упоминания бренда в AI?»;
- «Сравни пять поставщиков промышленного оборудования по цене, гарантии и сервису».
В коротком AI-ответе объем сравнения ограничен форматом запроса и выбранным режимом. Deep Research способен провести более развернутое исследование, включить несколько компаний в таблицу и привязать часть характеристик к источникам.
Для бренда это создает отдельный объект анализа: какие страницы агент находит, какие сведения о компании использует и на какие внешние площадки ссылается.
Чек-лист: как подготовить контент для исследовательских AI-агентов
1. Сделайте значимые данные доступными
Информация о компании, продуктах, ценах, характеристиках и исследованиях должна быть доступна без авторизации и других барьеров, если эти сведения предназначены для открытого распространения.
При технической подготовке сайта полезно учитывать, какие системы получают доступ к страницам и как устроена работа AI-краулеров.
2. Публикуйте первичные данные
Собственные исследования, методики, спецификации, тарифы и кейсы дают агенту фактуру, которую можно сопоставлять с другими источниками.
Цифры лучше сопровождать пояснением:
- что именно измеряли;
- за какой период;
- по какой методике;
- какая выборка использовалась;
- где находится первичный источник данных.
3. Ясно описывайте специализацию компании
На страницах сайта должно быть понятно, чем занимается компания, какие продукты предлагает и для каких задач они предназначены. Если одна и та же услуга называется на разных страницах по-разному, исследовательской системе сложнее корректно сопоставить сведения.
4. Следите за внешним информационным следом
Отраслевые СМИ, исследования, каталоги, рейтинги и другие профильные площадки создают дополнительные источники информации о бренде.
При этом количество публикаций само по себе не подтверждает факт. Несколько сайтов способны воспроизводить сведения из одного ошибочного первоисточника.
Для анализа площадок также можно использовать рейтинг источников нейросетей Pixel Tools.
5. Синхронизируйте факты о компании
Цена, название продукта, условия тарифа, характеристики и другие проверяемые сведения не должны расходиться между собственным сайтом и актуальными внешними материалами. Если источники противоречат друг другу, системе приходится выбирать между разными версиями факта или указывать расхождение.
6. Создавайте материалы под исследовательские вопросы
Особенно полезны страницы, которые содержат данные для сравнения:
- характеристики;
- ограничения;
- цены;
- методики;
- кейсы;
- результаты исследований;
- ответы на типовые вопросы;
- официальную документацию.
Такие материалы дают агенту больше конкретных сведений для анализа, чем общие рекламные формулировки.
Как отслеживать Deep Research в GEO
Deep Research стоит анализировать отдельно от коротких AI-ответов. Исследовательский отчет длиннее, а путь поиска способен отличаться при повторных запусках.
Практический алгоритм:
- Составьте набор промптов, которые соответствуют реальным исследовательским задачам аудитории.
- Запускайте одинаковые или сопоставимые запросы в нескольких релевантных AI-сервисах.
- Фиксируйте, появился ли бренд в отчете и в каком контексте.
- Сохраняйте источники, на которые ссылается система.
- Отмечайте компании, которые попадают в сравнение вместе с вашим брендом.
- Сравнивайте результаты нескольких запусков, а не одного.
- Отслеживайте динамику упоминаний, цитируемости и SOV.
Преимущества и ограничения Deep Research
|
Преимущества |
Ограничения |
|---|---|
|
Обрабатывает большой объем материалов за один исследовательский цикл |
Работает дольше обычного чата |
|
Возвращает ссылки или цитаты для проверки |
Может допускать фактические ошибки и неверные выводы |
|
Выполняет повторные поиски по мере исследования |
Качество зависит от найденных и выбранных источников |
|
Может работать с вебом и дополнительными источниками данных |
Набор подключений зависит от конкретного сервиса |
|
Удобен для сравнений и обзоров |
Требует больше вычислительных ресурсов |
|
Помогает быстро получить исследовательский черновик |
Финальные выводы по значимым вопросам требуют проверки человеком |
Доступ к закрытым или платным данным зависит от сервиса, подписки, разрешений пользователя и подключенных источников. Современные реализации Deep Research могут работать с корпоративными хранилищами и другими авторизованными источниками, если продукт поддерживает такое подключение.
Самые популярные термины