Модель эмбеддингов
Модель эмбеддингов (embedding model) — это обученная AI-модель, которая преобразует текст, изображение или другой объект в числовой вектор — набор чисел, отражающий признаки и смысл объекта. Благодаря этому система может математически сравнивать данные: находить тексты с близким смыслом, группировать похожие материалы, искать релевантные документы и отбирать информацию для RAG-систем.
OpenAI определяет embedding как вектор чисел, расстояние между которыми используется для оценки связанности текстов. Microsoft описывает embeddings сходным образом: как числовое представление семантического смысла, пригодное для поиска, рекомендаций, классификации и кластеризации.
Модель эмбеддингов и эмбеддинг — разные понятия. Модель выполняет преобразование, а эмбеддинг — полученный в результате вектор.
Как модель эмбеддингов представляет смысл текста
Компьютеру сложно непосредственно сравнить смысл фраз:
- «как повысить видимость компании в ответах ИИ»;
- «продвижение бренда в нейросетях»;
- «как сделать бренд заметнее в AI-поиске».
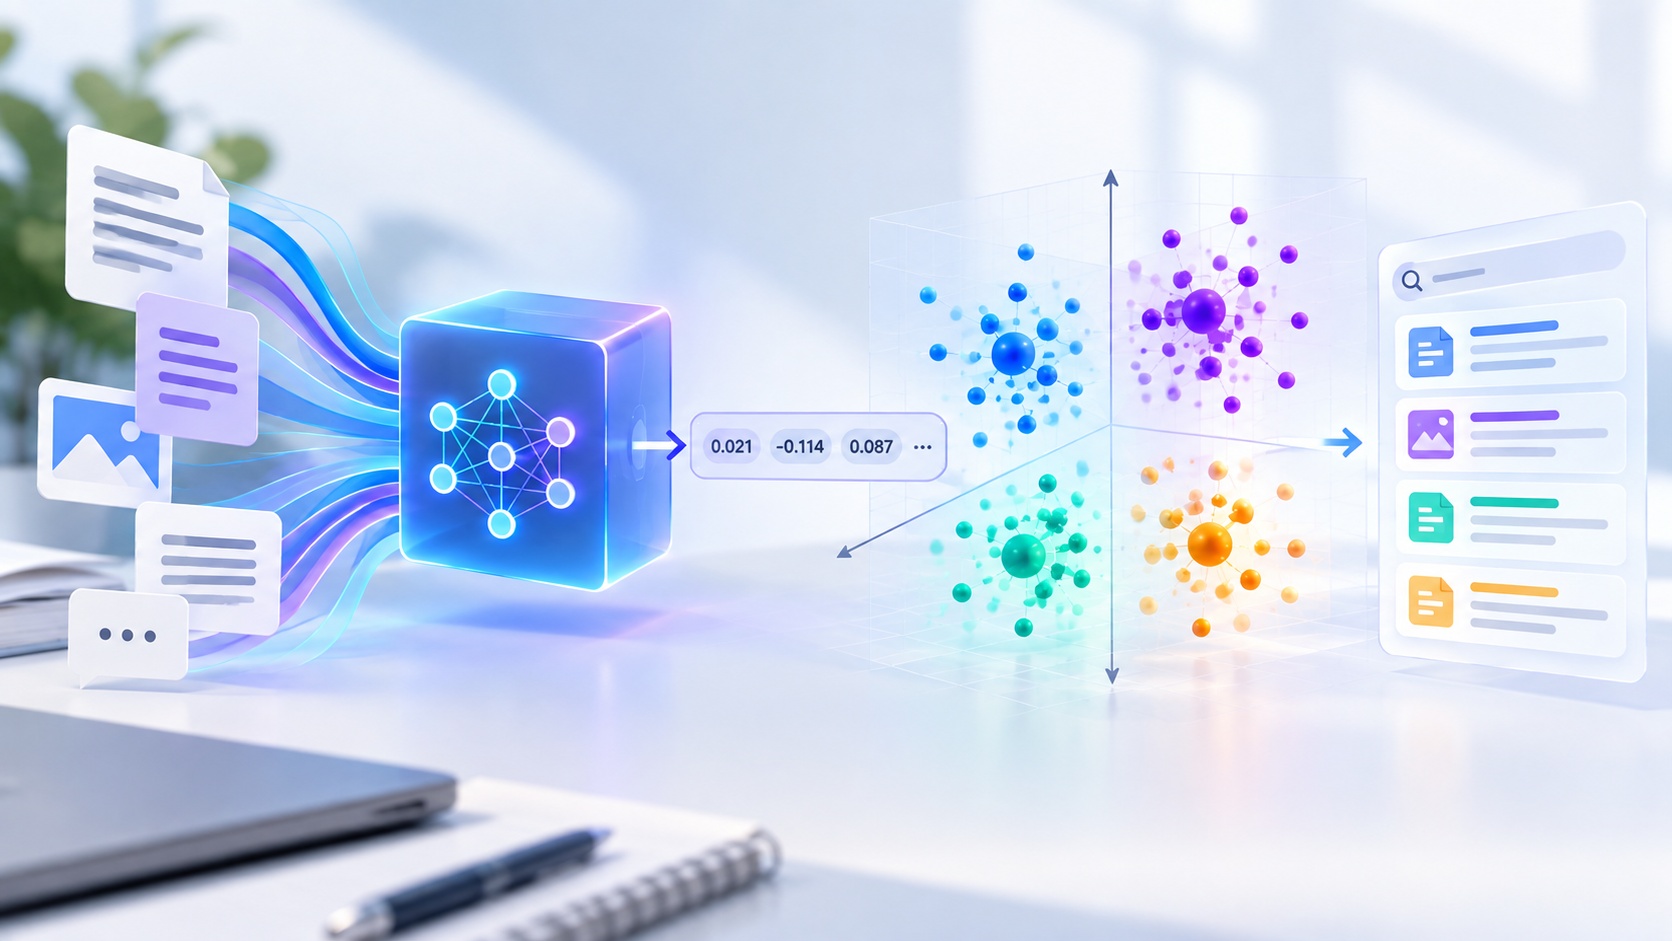
Набор слов у этих запросов различается, но тематика близкая. Модель эмбеддингов преобразует каждый текст в вектор, например:
[0,021; -0,114; 0,087; ...]
Отдельные координаты такого вектора обычно не интерпретируют как понятные человеку характеристики. Значение имеет положение вектора относительно других векторов в общем многомерном пространстве.
Тексты со схожей семантикой модель стремится расположить ближе друг к другу. Поэтому поиск способен найти релевантный документ даже без точного совпадения слов. Google описывает это свойство dense embeddings как возможность искать фрагменты, совпадающие с запросом по смыслу, а не только по словам или синтаксису.
Как работает модель эмбеддингов
В упрощенной схеме процесс выглядит так:
текст → модель эмбеддингов → числовой вектор → сравнение с другими векторами → поиск наиболее близких объектов
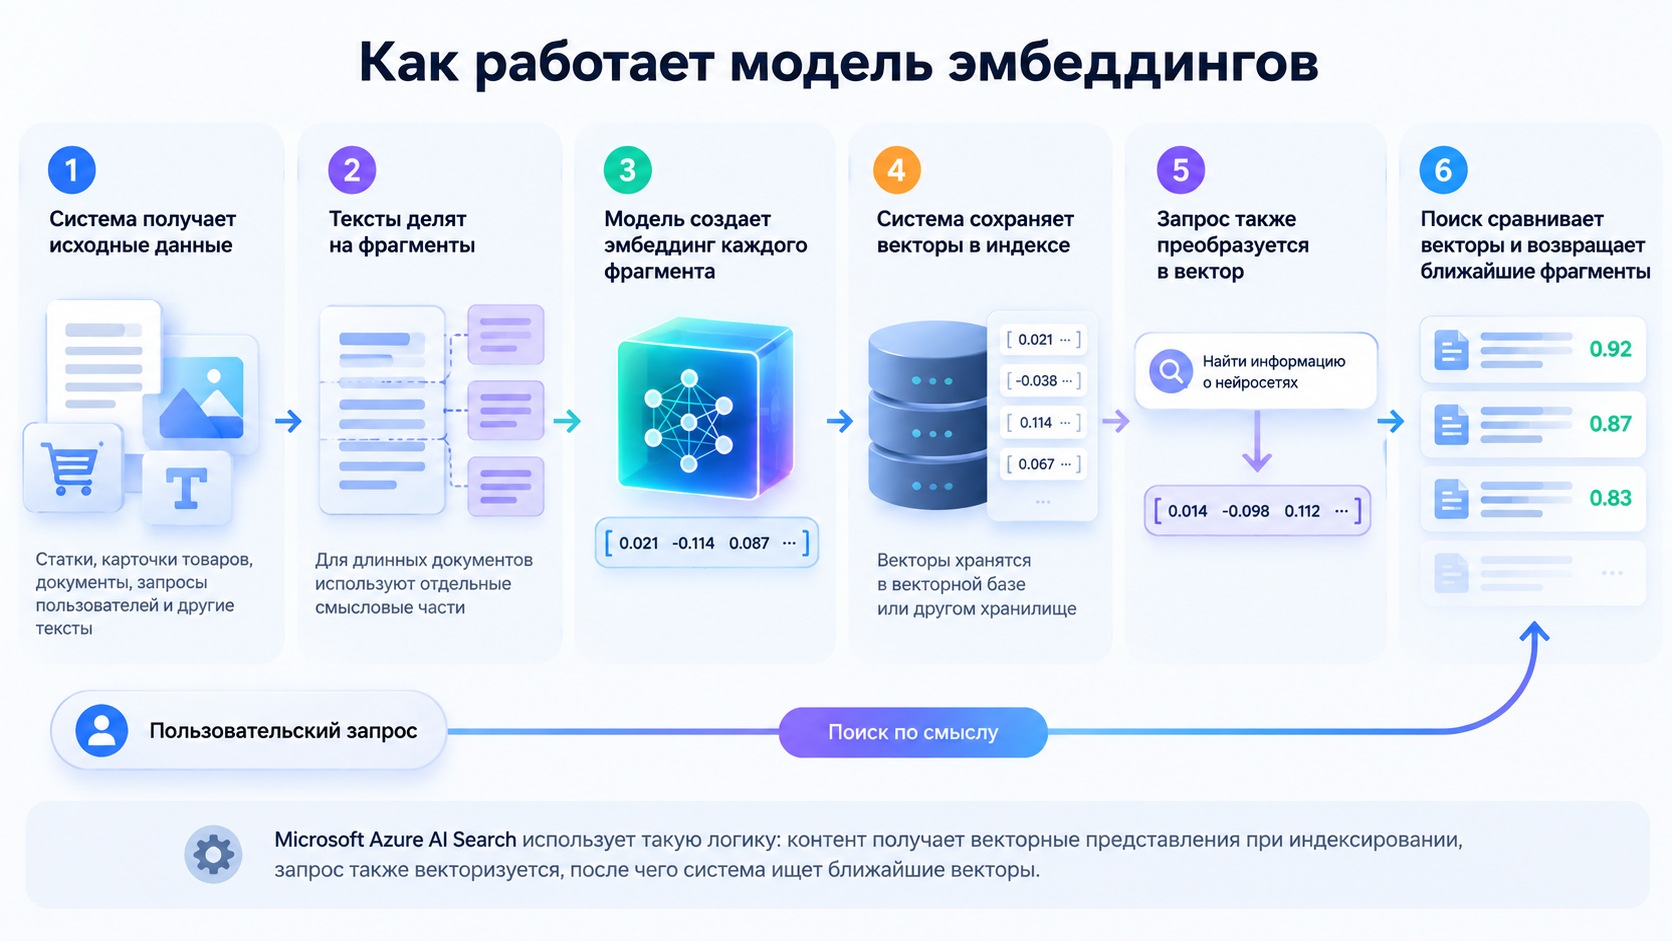
Для семантического поиска это обычно происходит в несколько этапов:
1. Система получает исходные данные. Это могут быть статьи, карточки товаров, справочные материалы, документы компании, запросы пользователей или другие тексты.
2. Тексты делят на подходящие фрагменты. Для длинных документов обычно используют отдельные смысловые части.
3. Модель создает эмбеддинг каждого фрагмента.
4. Система сохраняет векторы в индексе или другом хранилище.
5. Пользовательский запрос также преобразуется в вектор.
6. Поисковый алгоритм сравнивает вектор запроса с индексом и возвращает наиболее близкие фрагменты.
Microsoft Azure AI Search использует именно такую логику: контент получает векторные представления при индексировании, запрос также векторизуется, после чего система ищет ближайшие векторы.
Как измеряют близость векторов
Один из распространенных методов — косинусное сходство:
cos(a,b) = (a · b) / (||a|| × ||b||)
Метрика сравнивает направление двух векторов. Чем выше сходство, тем ближе модель считает их семантическое содержание.
OpenAI использует косинусное сходство в примерах поиска по embeddings и рекомендует его для своих векторов. Sentence Transformers также поддерживает cosine similarity наряду со скалярным произведением и несколькими метриками расстояния.
При этом высокий показатель сходства означает семантическую близость, а не достоверность текста. Два ошибочных утверждения могут быть очень похожи по смыслу.
Где применяются модели эмбеддингов
|
Задача |
Как используются эмбеддинги |
|---|---|
|
Семантический поиск |
Запрос сравнивается с векторами документов, после чего система находит близкие по смыслу фрагменты |
|
RAG |
Модель помогает найти контекст, который затем передается генеративной модели |
|
Кластеризация |
Похожие запросы, документы или отзывы объединяются в смысловые группы |
|
Рекомендации |
Система ищет материалы или объекты, похожие на уже интересующие пользователя |
|
Классификация |
Вектор сравнивается с примерами или векторами категорий |
|
Поиск дубликатов |
Система выявляет тексты с очень близким смысловым содержанием |
|
Анализ контента |
Эмбеддинги помогают сравнивать смысловое покрытие страниц, запросов и тематических кластеров |
OpenAI среди типовых сценариев перечисляет поиск, кластеризацию, рекомендации, обнаружение аномалий и классификацию.
Модель эмбеддингов, LLM, векторная база и реранкер: в чем разница
Эти компоненты часто встречаются в одной AI-системе, поэтому их легко смешать.
|
Компонент |
Что делает |
Результат |
|---|---|---|
|
Модель эмбеддингов |
Преобразует объект в вектор |
Набор чисел |
|
Эмбеддинг |
Представляет объект в векторном пространстве |
Готовый вектор |
|
Векторный индекс или база |
Хранит и ищет похожие векторы |
Список подходящих объектов |
|
Реранкер |
Повторно оценивает найденные кандидаты |
Более точный порядок результатов |
|
LLM |
Обрабатывает контекст и генерирует ответ |
Текст или другой результат |
Embedding-модель обычно не пишет готовый ответ пользователю. Она преобразует запросы и документы в векторы, чтобы система могла определить, какие материалы ближе друг к другу по смыслу.
Реранкер подключается после первичного поиска. Сначала embedding-модель быстро отбирает подходящие документы, затем реранкер сравнивает запрос с каждым найденным материалом и уточняет порядок результатов.
Например, Cross-Encoder анализирует запрос и документ вместе и оценивает, насколько они соответствуют друг другу. Bi-encoder работает иначе: он заранее создает отдельные векторы для запросов и документов, поэтому подходит для быстрого поиска по большому массиву данных. Такой подход называют retrieve & re-rank: сначала система находит кандидатов, затем повторно ранжирует их по релевантности.
Роль модели эмбеддингов в RAG
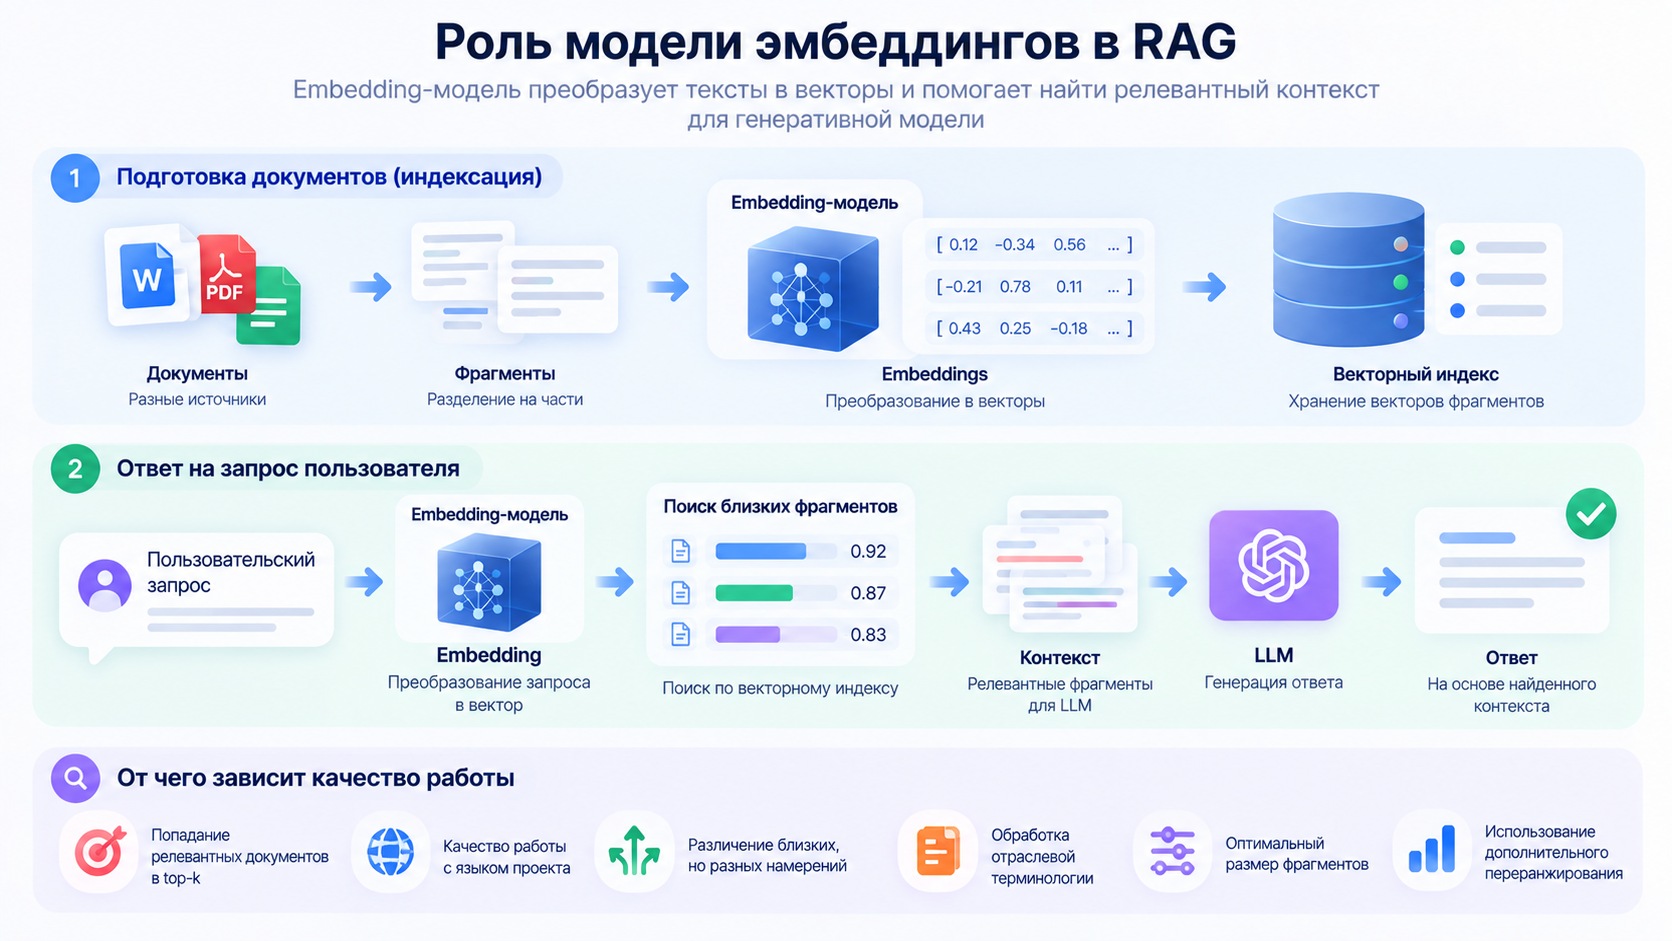
В RAG embedding-модель обычно отвечает за этап retrieval — поиск контекста для генеративной модели.
Схема выглядит так:
документы → фрагменты → embeddings → векторный индекс
После запроса пользователя:
запрос → embedding → поиск близких фрагментов → контекст → LLM → ответ
Microsoft приводит RAG как один из основных сценариев векторного поиска: поисковый индекс предоставляет данные, на которых затем основывается генеративный ответ.
Качество embedding-модели при такой архитектуре связано прежде всего с retrieval quality. Если нужный фрагмент не попал в выдачу поиска, генеративная модель может вообще не получить информацию, которая требовалась для ответа.
Поэтому при оценке RAG следует отдельно проверять:
- попадает ли релевантный документ в top-k результатов;
- насколько хорошо модель работает с языком проекта;
- различает ли близкие, но разные пользовательские намерения;
- как обрабатывает отраслевую терминологию;
- какой размер фрагментов дает лучшие результаты;
- помогает ли дополнительное переранжирование.
Симметричные и асимметричные задачи
Не все embedding-модели нужно использовать одинаково:
При симметричной задаче сравниваются объекты одного типа, например две статьи или два пользовательских запроса.
При поиске документов задача часто асимметричная: короткий запрос сравнивается с длинным документом.
Некоторые системы учитывают это явно. Google поддерживает разные типы задач, включая RETRIEVAL_QUERY для запроса и RETRIEVAL_DOCUMENT для документов. Yandex AI Studio также предоставляет отдельные варианты моделей для запросов и документов.
Поэтому правило «всегда используйте один и тот же идентификатор модели для запросов и документов» подходит не для всех архитектур. Корректнее говорить, что обе стороны должны находиться в совместимом векторном пространстве, предусмотренном разработчиком модели.
Как выбрать модель эмбеддингов
Универсально лучшей embedding-модели для всех задач нет. Исследование MTEB показало, что результаты моделей различаются в зависимости от типа задачи: retrieval, semantic similarity, clustering и другие сценарии требуют отдельной оценки.
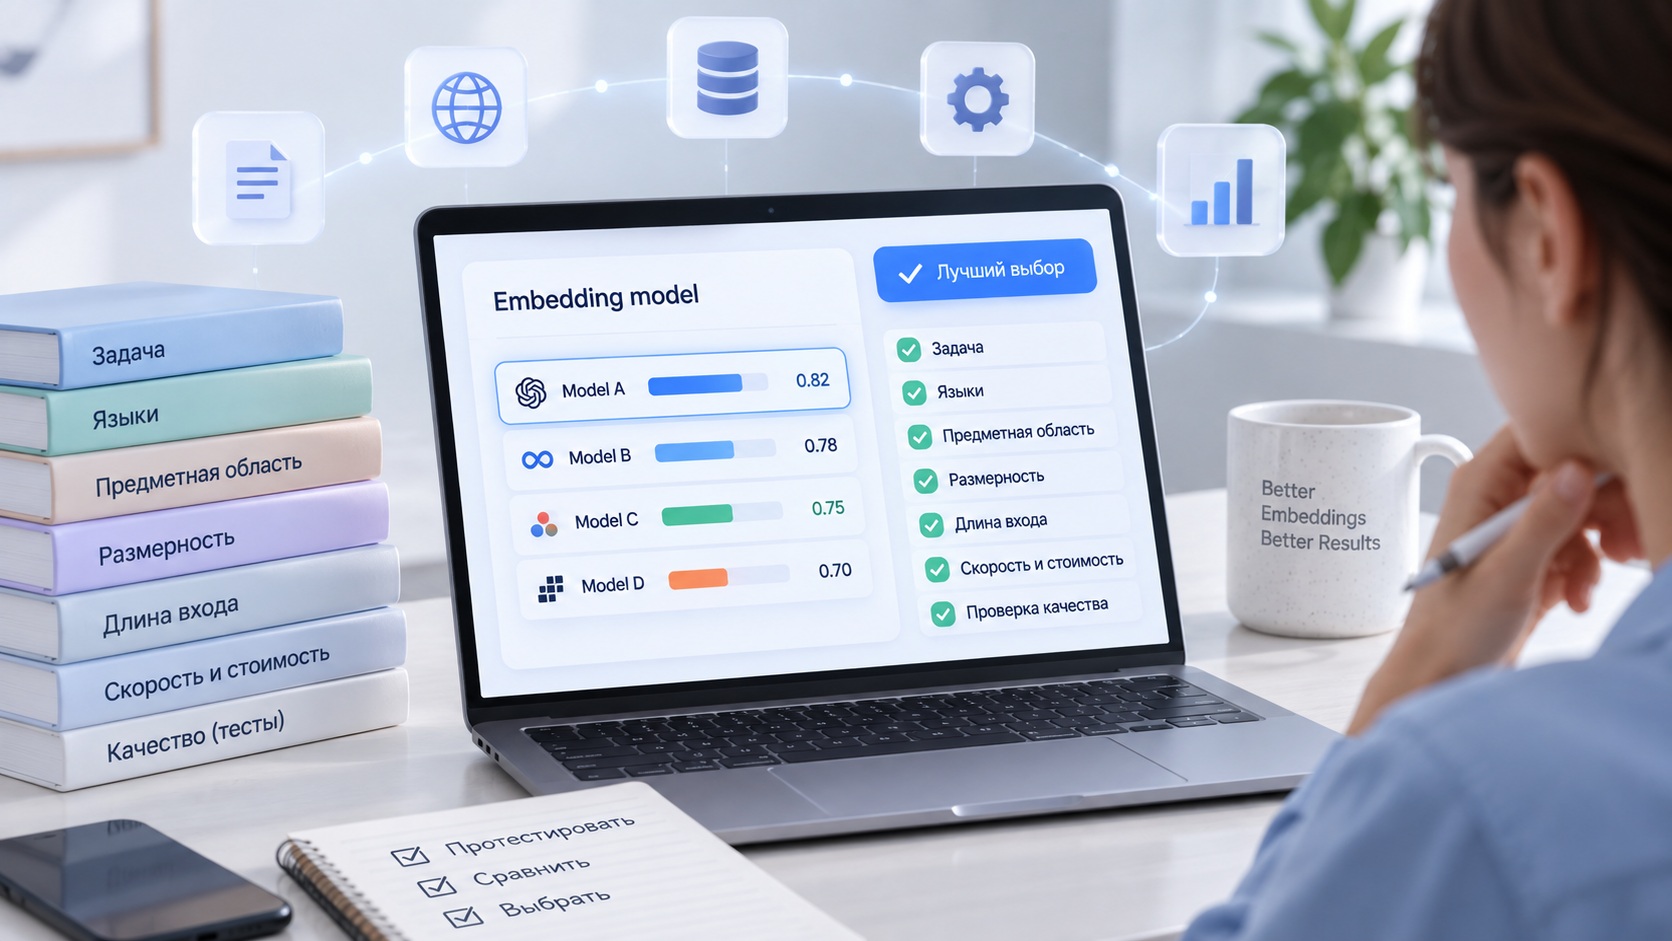
Практический выбор удобно строить по нескольким параметрам.
1. Задача
Сначала определяют, что потребуется от модели:
- поиск документов;
- сопоставление запроса и ответа;
- поиск похожих текстов;
- кластеризация;
- классификация;
- мультиязычный поиск.
Модель, которая хорошо определяет смысловую близость двух текстов, может хуже справляться с поиском подходящих документов по запросу.
2. Языки
Для русскоязычного проекта модель нужно проверять на русских текстах и запросах. Если она хорошо работает с английским языком, это не означает, что качество поиска на русском будет таким же. Для мультиязычного проекта тестируют все основные языки, с которыми будет работать система.
3. Предметная область
Юридические документы, медицина, электронная коммерция и GEO-аналитика используют разную лексику и разные смысловые связи. Для узкой области имеет смысл проверить специализированные или дообученные модели.
4. Размерность
Более компактный вектор требует меньше памяти и вычислений. Более высокая размерность иногда сохраняет больше информации, однако сравнивать модели только по этому параметру некорректно.
OpenAI прямо описывает уменьшение размерности как компромисс между производительностью модели и вычислительными затратами.
5. Максимальная длина входа и разбиение текста
У каждой embedding-модели есть ограничение на объем текста, который она может обработать за один раз. Но даже если в модель помещается целая большая статья, хранить ее как один вектор не всегда удобно: системе сложнее найти внутри нее конкретный факт.
Поэтому длинные материалы обычно делят на небольшие смысловые фрагменты — chunks. Отдельно подбирают их размер и степень перекрытия соседних частей, чтобы поиск находил нужный контекст без потери смысла.
6. Скорость и стоимость
При большом количестве документов системе нужно создать и сохранить много векторов. Кроме того, новый эмбеддинг формируется для каждого поискового запроса.
Поэтому при выборе модели оценивают, как быстро она работает, сколько стоит обработка данных и сколько места займут векторы. Для крупных проектов эти параметры могут заметно влиять на расходы и скорость поиска.
7. Качество на собственном наборе запросов
Финальный выбор лучше делать через тест:
- собрать реальные запросы;
- отметить релевантные документы;
- получить результаты нескольких моделей;
- сравнить retrieval-метрики;
- проверить типичные ошибки вручную.
Как модель эмбеддингов связана с GEO
В GEO (Generative Engine Optimization) embedding-модели полезны прежде всего как инструмент анализа семантики и построения собственных AI-систем.
GEO-специалист обычно не знает, какую embedding-модель использует ChatGPT, AI-поиск или другой внешний сервис. Разработчики могут не раскрывать устройство внутреннего поиска и способ сравнения документов.
Поэтому подстраивать текст под конкретные векторы такой системы нельзя. В GEO embeddings полезнее использовать для собственных задач: группировки промптов, сравнения страниц по смыслу, поиска контентных пробелов и анализа источников. Практическая ценность embeddings для GEO возникает в задачах, где команда контролирует собственный анализ.
Кластеризация GEO-промптов
Предположим, проект отслеживает сотни пользовательских формулировок:
- «какую CRM выбрать для интернет-магазина»;
- «CRM для ecommerce»;
- «лучшие системы управления клиентами для онлайн-магазина»;
- «сервис для работы с покупателями интернет-магазина».
Embedding-модель помогает объединить близкие формулировки в один смысловой кластер. В результате аналитик видит реальные группы интентов, а не длинный перечень похожих запросов.
Поиск пробелов в контенте
Можно создать embeddings:
- GEO-промптов;
- страниц собственного сайта;
- материалов конкурентов;
- страниц, которые появляются среди источников AI-ответов.
После этого система сравнивает векторы и показывает, для каких групп запросов у бренда нет близкого по смыслу материала.
Пример:
|
GEO-задача |
Что анализируют через embeddings |
Что получает специалист |
|---|---|---|
|
Группировка промптов |
Сходство запросов |
Кластеры пользовательских интентов |
|
Анализ контента |
Промпты ↔ страницы |
Темы без подходящего материала |
|
Анализ конкурентов |
Промпты ↔ страницы конкурентов |
Контент, закрывающий интент лучше |
|
Анализ источников |
Запросы ↔ цитируемые документы |
Тематически релевантные площадки и материалы |
|
Поиск дублей |
Страница ↔ страница |
Семантически похожий контент |
При этом семантическая близость страницы к промпту еще не означает, что нейросеть обязательно выберет ее источником. В GEO учитываются и другие характеристики: присутствие бренда на внешних площадках, контекст упоминаний, авторитет источника, структура контента и доступность страницы.
Пример использования embedding-модели в GEO-анализе
Допустим, компания хочет понять, закрывает ли ее сайт запросы пользователей о выборе сервиса аналитики.
Есть:
- 500 промптов;
- 150 страниц сайта;
- материалы конкурентов;
- список источников, которые встречаются в AI-ответах.
Алгоритм:
- Модель создает embeddings всех промптов.
- Аналитическая система группирует похожие запросы.
- Та же совместимая модель создает embeddings страниц.
- Для каждого кластера система находит наиболее близкие материалы.
- Кластеры без релевантной страницы попадают в список контентных пробелов.
- Аналитик изучает, какие документы конкурентов и внешние источники закрывают эти темы.
- После публикации или обновления материалов результат проверяют уже на реальных AI-ответах и источниках.
Embedding-модель здесь помогает масштабировать семантический анализ. Она не определяет самостоятельно, попадет ли бренд в ответ конкретной нейросети.
Преимущества и ограничения моделей эмбеддингов
|
Преимущество |
Ограничение |
|---|---|
|
Поиск по смыслу без точного совпадения слов |
Семантическая близость не гарантирует фактическую достоверность |
|
Быстрое сравнение большого числа документов после индексирования |
Индекс приходится обновлять при смене embedding-модели |
|
Подходит для поиска, кластеризации и рекомендаций |
Качество различается между языками и предметными областями |
|
Помогает строить RAG и семантическую аналитику |
Результат зависит от подготовки данных и разбиения документов |
|
Векторы удобно индексировать |
Дополнительная инфраструктура увеличивает сложность системы |
Типичные ошибки при работе с моделью эмбеддингов
Сравнивать векторы из разных моделей
Разные embedding-модели создают векторы по своим правилам. Поэтому вектор, полученный одной моделью, обычно нельзя корректно сравнивать с вектором другой модели. Если проект переходит на новую модель, документы обычно обрабатывают заново и создают новый векторный индекс.
Выбирать модель только по размерности
Больше координат не означает лучшее качество. Например, модель с вектором из 3072 чисел может уступать модели с 768 числами на конкретной задаче. Сравнивать модели лучше на реальных запросах проекта: проверить, насколько точно они находят нужные документы, а затем учитывать скорость, стоимость и размер индекса.
Оценивать модель не на той задаче
Одна модель может хорошо определять, похожи ли два текста по смыслу, но хуже находить нужный документ по пользовательскому запросу. Поэтому модель нужно тестировать именно на той задаче, для которой ее планируют использовать. Различия между такими сценариями учитывает и бенчмарк MTEB.
Не учитывать разницу между запросом и документом
Некоторые модели по-разному обрабатывают поисковый запрос и текст документа. Например, Google использует отдельные режимы RETRIEVAL_QUERY для запроса и RETRIEVAL_DOCUMENT для документа. Если использовать неподходящий режим, качество поиска может снизиться. Поэтому перед настройкой поиска нужно проверить рекомендации для выбранной модели.
Считать высокое сходство признаком качественного контента
Embedding-модель оценивает, насколько два текста близки по смыслу. Она сама по себе не определяет, достоверна ли информация, насколько авторитетен источник и актуален ли материал. Для GEO это тоже имеет значение. Если страница по смыслу очень близка к промпту, это еще не означает, что ChatGPT, AI-поиск или другая нейросеть выберет ее источником или упомянет бренд в ответе.
Самые популярные термины